6. Aprendizaje automático clásico
This content is not available in your language yet.
De la teoría general al primer algoritmo concreto
Sección titulada «De la teoría general al primer algoritmo concreto»Los cinco capítulos anteriores de este libro construyeron, pieza por pieza, todo lo necesario para llegar a este punto sin atajos: qué es la inteligencia en sus distintas tradiciones, cómo se dividió la historia del campo entre el paradigma simbólico y el conexionista, por qué el aprendizaje a partir de ejemplos es un acto de inducción que la teoría estadística del aprendizaje aprendió a medir sin poder justificar con certeza absoluta, qué lenguaje matemático —vectores, matrices, derivadas, probabilidades— hace falta para expresar ese aprendizaje con precisión, y sobre qué máquina física, con sus propios límites de memoria y energía, se ejecuta finalmente todo eso. Este capítulo da el primer paso concreto de la segunda parte de este libro: presenta, con todo el detalle matemático correspondiente, los algoritmos estadísticos más simples que sirven de puente hacia las redes neuronales que ocuparán el próximo capítulo. Los dos modelos que se desarrollan a continuación pertenecen, históricamente, a la tradición estadística clásica más que al paradigma conexionista propiamente dicho —tal como se lo caracterizó en el capítulo dedicado a la historia de la inteligencia artificial de este libro—; los presentamos aquí precisamente porque, como se verá, comparten la misma estructura matemática elemental que después se convertirá, apilada y con no linealidades intercaladas, en la neurona artificial del capítulo siguiente.
Cuatro maneras de aprender de datos
Sección titulada «Cuatro maneras de aprender de datos»Antes de entrar en ningún algoritmo concreto, conviene tener el mapa completo de las formas en que un sistema puede aprender a partir de datos, porque este libro va a desarrollar algunas con detalle y otras solo lo suficiente para que el lector reconozca de qué se está hablando cuando aparezcan.
La primera familia, y la más directa de entender, es el aprendizaje supervisado. Se le presentan al sistema ejemplos acompañados de la respuesta correcta: solicitudes de crédito junto con el dato de si fueron devueltas o no, radiografías junto con el diagnóstico confirmado por un especialista, correos electrónicos junto con la etiqueta de si eran publicidad no deseada. El sistema ajusta sus parámetros internos hasta reducir al mínimo la cantidad de errores que comete sobre esos ejemplos conocidos, con la esperanza de que ese ajuste le sirva también para casos nuevos. La palabra “supervisado” viene precisamente de que alguien —típicamente un ser humano— tuvo que proporcionar de antemano la respuesta correcta de cada ejemplo. Esta familia es la que el resto de este capítulo desarrolla en detalle.
La segunda familia es el aprendizaje no supervisado. Aquí el sistema recibe datos sin ninguna respuesta correcta asociada, y su tarea consiste en encontrar por sí mismo alguna estructura interesante dentro de ellos. El caso más común es el agrupamiento: dado un conjunto de clientes descritos por sus hábitos de compra, sin que nadie haya definido de antemano categorías de cliente, el sistema identifica qué grupos de clientes se parecen entre sí y se diferencian de los demás. Nótese la diferencia decisiva con la familia anterior: nadie le dijo al sistema cuántos grupos debía haber ni qué caracterizaba a cada uno; el sistema los propuso a partir de la estructura de los propios datos. Esto tiene una consecuencia epistemológica que conviene retener: los grupos que un sistema de este tipo encuentra son regularidades estadísticas, no categorías validadas, y su interpretación —decidir qué significa cada grupo y si tiene algún sentido en el mundo real— sigue siendo una tarea humana.
La tercera familia es el aprendizaje auto-supervisado, y es probablemente la más importante para entender los sistemas actuales, aunque su nombre resulte menos conocido fuera del campo. Consiste en construir una tarea de tipo supervisado a partir de datos que no venían etiquetados por nadie, usando la propia estructura de esos datos para generar automáticamente tanto la pregunta como la respuesta correcta. El ejemplo canónico, que el capítulo 8 desarrolla en detalle, es el entrenamiento de un modelo de lenguaje: se toma un texto cualquiera ya existente en el mundo, se le oculta al sistema la palabra siguiente, se le pide que la prediga, y se compara su predicción con la palabra que efectivamente estaba ahí. Nadie tuvo que etiquetar nada: el texto mismo proporciona, de manera gratuita y a una escala enorme, tanto los ejemplos como sus respuestas correctas. Esta es, en el fondo, la razón por la cual estos sistemas pudieron entrenarse sobre cantidades de datos que ninguna operación de etiquetado manual habría podido producir jamás.
La cuarta familia es el aprendizaje por refuerzo, y su lógica es distinta de las tres anteriores. Aquí no hay un conjunto fijo de ejemplos, sino un sistema —llamado agente— que actúa dentro de un entorno, observa qué ocurre como consecuencia de sus acciones, y recibe alguna señal de recompensa o penalización que le indica qué tan bien le fue. A partir de esa experiencia acumulada, el agente ajusta su manera de decidir qué hacer en cada situación, buscando maximizar la recompensa que obtiene a lo largo del tiempo. Un sistema que aprende a jugar un juego probando jugadas y observando si gana o pierde, un robot que aprende a caminar cayéndose y corrigiéndose, o un sistema de control que ajusta la temperatura de un edificio observando el consumo energético resultante, son todos ejemplos de esta familia.
Conviene notar que esta cuarta familia cierra un círculo que este libro abrió en su primer capítulo. Cuando Norbert Wiener describió, en 1948, cualquier sistema adaptativo —biológico o artificial— como un bucle en el que un sistema percibe su entorno, actúa sobre él, y vuelve a percibir el resultado de su propia acción, estaba describiendo, en un lenguaje anterior a la existencia del campo, exactamente la estructura que el aprendizaje por refuerzo formaliza hoy: percibir, actuar, observar la consecuencia, ajustar. La cibernética de Wiener y el aprendizaje por refuerzo contemporáneo son, en su esqueleto conceptual, la misma idea separada por setenta años de desarrollo técnico.
Este libro desarrolla con detalle el aprendizaje supervisado —en el resto de este capítulo y en el siguiente— y el auto-supervisado, en el capítulo dedicado a los modelos de lenguaje. Presenta el aprendizaje no supervisado y el aprendizaje por refuerzo de manera conceptual, sin desarrollar sus algoritmos, porque ambos resultan necesarios para comprender temas que sí se tratan más adelante: el refuerzo, en particular, reaparece al explicar cómo se ajustan los sistemas conversacionales para seguir instrucciones, y al examinar los sistemas agentes de la investigación actual.
El problema de aprendizaje supervisado
Sección titulada «El problema de aprendizaje supervisado»Conviene ahora precisar el vocabulario del aprendizaje supervisado, porque es el que este libro va a usar de manera constante. Se dispone de un conjunto de ejemplos de entrenamiento, cada uno compuesto por un vector de características y una etiqueta asociada. Un vector de características no es más que la lista ordenada de números con la que se representa un dato del mundo: una casa descrita por su superficie, su cantidad de habitaciones y su antigüedad es un vector de tres números, siempre en ese mismo orden. La etiqueta es el valor correcto que se espera que el sistema aprenda a predecir para ese vector. El capítulo 4 desarrolla en detalle esta manera de representar datos como vectores y las operaciones que se pueden hacer con ellos. Si el objetivo es predecir el precio de una casa a partir de su superficie, su cantidad de habitaciones y su antigüedad, cada ejemplo de entrenamiento es el vector de esas tres características, y su etiqueta es el precio real al que esa casa se vendió. El objetivo del aprendizaje supervisado es encontrar una función que, aplicada a un vector de características nunca visto durante el entrenamiento, prediga una etiqueta razonablemente cercana a la que ese caso tendría en la realidad. Esta descripción no es más que la traducción, a un vocabulario concreto, del marco de minimización del riesgo empírico que el capítulo dedicado a la lógica y la epistemología de este libro presentó de manera abstracta.
Cuando la etiqueta que se busca predecir es un número que puede tomar cualquier valor dentro de un rango continuo —como el precio de una casa—, el problema se llama de regresión. Cuando la etiqueta es, en cambio, una de entre un conjunto limitado de categorías posibles —como determinar si un correo electrónico es publicidad no deseada o no lo es—, el problema se llama de clasificación. Este capítulo presenta un algoritmo representativo de cada uno de estos dos tipos de problema, elegidos precisamente por ser los más simples posibles, porque esa simplicidad es lo que permite ver, sin ningún ocultamiento, el mecanismo completo de ajuste de parámetros que sostiene también a los modelos mucho más complejos que se presentarán en el resto de este libro.
La regresión lineal: el modelo más simple posible
Sección titulada «La regresión lineal: el modelo más simple posible»El modelo de regresión lineal predice la etiqueta como una combinación lineal de las características de entrada: se multiplica cada característica por un peso ajustable propio de esa característica, se suman todos esos productos, y se agrega, al final, un término adicional llamado sesgo, que permite desplazar la predicción hacia arriba o hacia abajo independientemente de las características de entrada. Esta operación —multiplicar cada característica por su peso correspondiente y sumar todos los resultados— tiene un nombre en álgebra lineal, producto interno, y resulta ser, sin ningún adorno adicional, la operación básica sobre la que se construyen también las redes neuronales de los capítulos siguientes. El capítulo 4 la desarrolla en detalle.
El objetivo del entrenamiento es encontrar los valores de esos pesos y de ese sesgo que hagan que las predicciones del modelo se acerquen lo más posible a las etiquetas reales, sobre el conjunto de ejemplos de entrenamiento disponible. Para medir qué tan lejos está una predicción de la etiqueta real, se usa habitualmente una función de pérdida llamada error cuadrático medio, que calcula, para cada ejemplo, la diferencia entre la predicción y la etiqueta real, eleva esa diferencia al cuadrado —para que los errores por exceso y por defecto cuenten de la misma manera, y para penalizar más fuertemente a los errores grandes que a los pequeños—, y promedia ese resultado sobre todos los ejemplos del conjunto de entrenamiento. Esta función de pérdida es, precisamente, el riesgo empírico del capítulo dedicado a la epistemología de este libro, particularizado para este problema concreto.
La regresión logística: de predecir un número a estimar una probabilidad
Sección titulada «La regresión logística: de predecir un número a estimar una probabilidad»Cuando el problema es de clasificación y no de regresión —por ejemplo, decidir si un correo es publicidad no deseada—, una salida que puede tomar cualquier valor numérico, como la de la regresión lineal, no resulta directamente interpretable como una decisión entre dos categorías. La regresión logística resuelve este problema con un ajuste tan simple como decisivo: toma la misma combinación lineal de características y pesos que ya se definió para la regresión lineal, y la pasa a través de una función adicional, llamada función sigmoide, que comprime cualquier número real, sin importar cuán grande o cuán pequeño sea, en un valor entre cero y uno. Ese valor final se interpreta como una probabilidad condicional: la probabilidad de que el ejemplo pertenezca a la categoría positiva, dado el vector de características observado. El capítulo 4 desarrolla el lenguaje formal de la probabilidad en el que se apoya esta interpretación.
Para entrenar este modelo hace falta una función de pérdida distinta del error cuadrático medio, porque ese error, pensado originalmente para predecir números continuos, no captura bien lo que significa equivocarse al estimar una probabilidad. La función de pérdida que se usa en su lugar se llama entropía cruzada, y su nombre no es casual: es, literalmente, una aplicación directa de la teoría de la información de Claude Shannon presentada en el primer capítulo de este libro. La entropía cruzada mide, para cada ejemplo, cuánta “sorpresa” le produce al modelo la etiqueta real, dada la probabilidad que el modelo le había asignado de antemano a esa etiqueta. Si el modelo asignó una probabilidad alta a la etiqueta que efectivamente ocurrió, la sorpresa —y por lo tanto la pérdida— es baja; si el modelo asignó una probabilidad baja a la etiqueta que terminó ocurriendo, la sorpresa, y la pérdida, son altas. Entrenar un clasificador mediante entropía cruzada es, entonces, ajustar sus parámetros para que las probabilidades que asigna resulten, en promedio, lo menos sorprendentes posible frente a las etiquetas reales que efectivamente se observan, un objetivo que es, en el fondo, exactamente la misma minimización de incertidumbre que el primer capítulo de este libro presentó como el núcleo de la teoría de Shannon, aplicada ahora no a un canal de comunicación sino al proceso de aprendizaje de un modelo estadístico.
Conviene hacer aquí dos precisiones que un curso riguroso no puede pasar por alto. La primera es puramente convencional: cuando el primer capítulo de este libro definió la entropía en bits, esa unidad depende de usar el logaritmo en base dos. En la práctica del aprendizaje automático, la entropía cruzada se calcula casi siempre con el logaritmo natural, y la unidad resultante no son bits sino nats; la interpretación conceptual —cuánta “sorpresa” mide la pérdida— es idéntica en ambos casos, y la elección de la base del logaritmo no cambia en absoluto qué parámetros terminan siendo óptimos, pero conviene no repetir sin más la palabra “bits” cuando, en la implementación real, la unidad que se está calculando son nats.
La segunda precisión es conceptual y más importante: que la salida de una regresión logística se interprete como una probabilidad en sentido formal no significa que esa salida esté necesariamente bien calibrada como una probabilidad en el sentido práctico del término. Un modelo está bien calibrado cuando, entre todos los casos a los que asignó, por ejemplo, un setenta por ciento de probabilidad de pertenecer a la categoría positiva, efectivamente alrededor del setenta por ciento de esos casos pertenecen a esa categoría en la realidad. Nada en el proceso de entrenamiento por entropía cruzada garantiza, por sí solo, esa correspondencia exacta entre el número que el modelo produce y la frecuencia real del fenómeno que ese número pretende describir; verificar y corregir la calibración de un modelo es, de hecho, un paso adicional y distinto de simplemente entrenarlo para minimizar su pérdida.
El sobreajuste: cuando el modelo memoriza en lugar de aprender
Sección titulada «El sobreajuste: cuando el modelo memoriza en lugar de aprender»El capítulo dedicado a la lógica y la epistemología de este libro ya adelantó, en términos abstractos, que la cantidad de datos necesaria para confiar en una inducción depende de la complejidad de la familia de reglas entre las que el modelo busca. Este apartado hace concreta esa advertencia con el ejemplo más simple posible. Si al modelo de regresión lineal presentado antes se le permite usar, en lugar de una simple combinación lineal de las características originales, combinaciones de esas características elevadas a potencias cada vez más altas —el cuadrado, el cubo, y así sucesivamente—, la familia de funciones que el modelo puede representar se vuelve cada vez más flexible, capaz de curvarse de maneras cada vez más elaboradas para pasar exactamente por cada uno de los puntos del conjunto de entrenamiento, incluido el ruido aleatorio propio de cualquier medición del mundo real.
Un modelo así, entrenado sobre un número limitado de ejemplos, puede llegar a tener un riesgo empírico —el error medido sobre esos mismos ejemplos de entrenamiento— prácticamente igual a cero, y sin embargo comportarse de manera errática y con un riesgo real muy alto frente a cualquier ejemplo nuevo que no haya visto durante el entrenamiento. Este fenómeno, llamado sobreajuste, es la manifestación práctica exacta del resultado teórico de Vapnik y Chervonenkis presentado en el capítulo dedicado a la epistemología de este libro: una familia de funciones demasiado flexible, entrenada con datos insuficientes para su nivel de flexibilidad, encuentra con facilidad una función que se ajusta perfectamente al ruido específico de la muestra de entrenamiento, en lugar de al patrón general subyacente que se querría capturar.
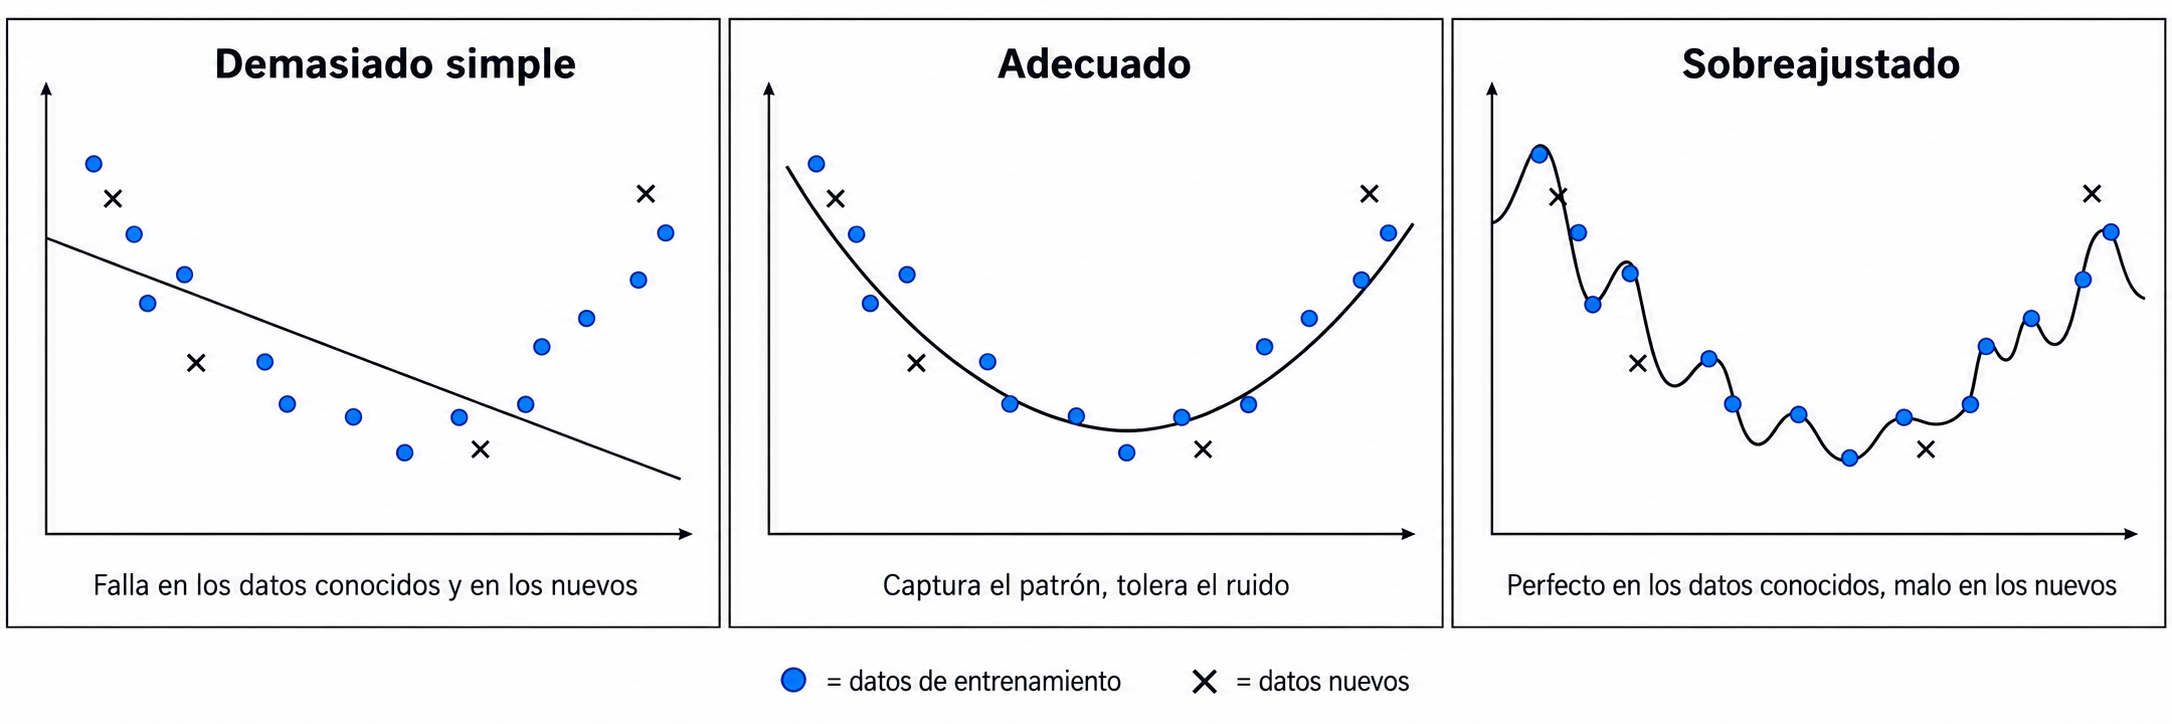
Figura 6.1. El sobreajuste. Un modelo suficientemente flexible puede pasar exactamente por todos los datos de entrenamiento ajustándose a su ruido accidental, y por eso mismo funcionar peor sobre datos nuevos que un modelo más simple. Un error de cero sobre los datos conocidos no es señal de éxito.
El límite estructural que motiva el próximo capítulo
Sección titulada «El límite estructural que motiva el próximo capítulo»Tanto la regresión lineal como la regresión logística comparten una limitación que este libro ya anticipó, sin resolverla, en el capítulo dedicado a la historia de la inteligencia artificial: ambas son, en su núcleo matemático, modelos lineales, es decir, su capacidad de decisión se reduce, geométricamente, a trazar una única línea recta —o, en más de dos dimensiones, un único plano o hiperplano— que separa una región del espacio de características de otra. El recuadro matemático de ese capítulo, dedicado a la disyunción exclusiva estudiada por Minsky y Papert, mostró con precisión que existen problemas de clasificación extremadamente simples que ningún modelo lineal, sin importar cómo se ajusten sus pesos, puede resolver, porque las dos categorías que hay que separar no se pueden dividir mediante una única línea recta.
Esta limitación no es un defecto menor ni un caso patológico infrecuente: es una restricción estructural inherente a cualquier modelo, como los presentados en este capítulo, que calcula su salida mediante una única combinación lineal de las características de entrada, sin importar qué tan cuidadosamente se elija la función de pérdida ni cuánto se entrene el modelo. Superar esta restricción exige, como el propio libro de Minsky y Papert ya reconocía en 1969, apilar varias de estas unidades en capas sucesivas, de manera que la salida de unas alimente a las siguientes. El próximo capítulo de este libro retoma exactamente ese punto, y presenta, con todo el desarrollo matemático que este capítulo dejó preparado, la arquitectura de redes neuronales que hace posible ese apilamiento, y el algoritmo de retropropagación que, diecisiete años más tarde, aportó un método práctico para entrenar esa arquitectura.
Al terminar este capítulo, usted debería poder explicar
Sección titulada «Al terminar este capítulo, usted debería poder explicar»- Cuáles son las cuatro grandes familias de aprendizaje automático, y en qué se diferencia cada una respecto de quién proporciona la respuesta correcta durante el entrenamiento.
- Qué significa, en términos concretos, que un modelo “ajuste sus parámetros” para reducir su error, y qué papel cumple la derivada en ese proceso.
- Por qué la regresión logística produce una probabilidad y no una decisión, y por qué esa probabilidad no está necesariamente bien calibrada.
- Qué es el sobreajuste, por qué no se detecta mirando el error sobre los datos de entrenamiento, y para qué sirve separar un conjunto de validación de un conjunto de prueba.
- Por qué ningún modelo lineal puede resolver el problema de la disyunción exclusiva, y qué hace falta para superar esa limitación.
Notas y referencias del capítulo
Sección titulada «Notas y referencias del capítulo»- Sobre el marco general del aprendizaje supervisado y los algoritmos clásicos de regresión y clasificación: Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning (2ª edición). Springer.
- Sobre la regresión logística y su formulación probabilística: Bishop, C. M. (2006). Pattern Recognition and Machine Learning, Capítulo 4. Springer. (Ya citado en el capítulo de fundamentos matemáticos.)
- Sobre la entropía cruzada como función de pérdida derivada de la teoría de la información de Shannon: Cover, T. M. & Thomas, J. A. (2006). Elements of Information Theory (2ª edición). Wiley.
- Sobre la regularización y su justificación en la teoría estadística del aprendizaje: Tikhonov, A. N. (1963). “On the Solution of Ill-Posed Problems and the Method of Regularization”. Doklady Akademii Nauk SSSR, 151. (Origen de la regularización conocida como de Tikhonov o L2.)
- Vapnik, V. N. (1998). Statistical Learning Theory. Wiley. (Ya citado en el capítulo de fundamentos lógicos y epistemológicos; se retoma aquí como fundamento directo del sobreajuste.)
Copyright © 2026 Carlos Dagorret — Licensed under Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International (CC BY-NC-ND 4.0)