4. Fundamentos matemáticos
This content is not available in your language yet.
Por qué este capítulo no podía llegar antes
Sección titulada «Por qué este capítulo no podía llegar antes»Los tres capítulos anteriores de este libro construyeron, con toda intención, el terreno conceptual completo antes de escribir una sola fórmula que no fuera estrictamente necesaria para ilustrar una idea puntual. Se explicó qué es la inteligencia en sus distintas tradiciones filosóficas y biológicas, se narró la historia del campo como una disputa entre dos escuelas, y se estableció con rigor lógico por qué una de esas escuelas —la conexionista, la que hoy domina el campo— descansa sobre un tipo de razonamiento inductivo que la teoría estadística del aprendizaje aprendió a medir, aunque nunca a justificar con certeza absoluta.
Todo ese terreno conceptual, sin embargo, se describió hasta aquí en prosa, con analogías y con ejemplos verbales. Este capítulo existe para dar el paso que todavía faltaba: proporcionar el lenguaje matemático exacto en el que esas mismas ideas se expresan cuando se construye, de verdad, un sistema de aprendizaje automático. No se trata de una matemática distinta de la que ya se mencionó de pasada en capítulos anteriores —el vector de parámetros que se ajusta mediante retropropagación, la entropía que mide la incertidumbre de Shannon, la familia de reglas cuya complejidad determina cuántos datos hacen falta según la teoría de Vapnik y Chervonenkis— sino, precisamente, la explicación completa y autónoma de esos mismos objetos, para que el lector pueda manipularlos por sí mismo y no solamente reconocerlos cuando aparecen mencionados.
Este capítulo está organizado en tres partes, que corresponden a tres preguntas distintas y complementarias. El álgebra lineal responde a la pregunta de cómo se representa un dato dentro de una máquina. El cálculo diferencial responde a la pregunta de cómo un sistema, dado un error medido, sabe en qué dirección ajustar sus propios parámetros para reducirlo. Y la teoría de la probabilidad responde a la pregunta de cómo se razona, de manera matemáticamente disciplinada, sobre la incertidumbre que la inducción, según mostró el capítulo anterior, nunca puede eliminar por completo.
Álgebra lineal: cómo se representa un dato
Sección titulada «Álgebra lineal: cómo se representa un dato»Todo objeto que un sistema de cómputo deba procesar —una fotografía, una palabra, la temperatura de un paciente, el precio histórico de una acción— tiene que representarse antes mediante datos, y con mucha frecuencia esa representación adopta la forma de una lista ordenada de números. Esa lista ordenada de números es lo que el álgebra lineal llama un vector. Si se quiere describir, por ejemplo, una casa mediante tres características —su superficie en metros cuadrados, su cantidad de habitaciones, y su antigüedad en años—, esa casa queda representada por un vector de tres números, cada uno en una posición fija que siempre significa lo mismo: la primera posición siempre es la superficie, la segunda siempre es la cantidad de habitaciones, la tercera siempre es la antigüedad. La cantidad de números que componen un vector se llama su dimensión; el vector de la casa tiene dimensión tres, pero una fotografía digital pequeña, en la que cada píxel se representa por un número, puede necesitar un vector de varios miles de dimensiones, y un párrafo de texto, según se explicará en la parte de este libro dedicada a los modelos de lenguaje, puede requerir vectores de varios miles de dimensiones también, aunque representando algo completamente distinto de un píxel.
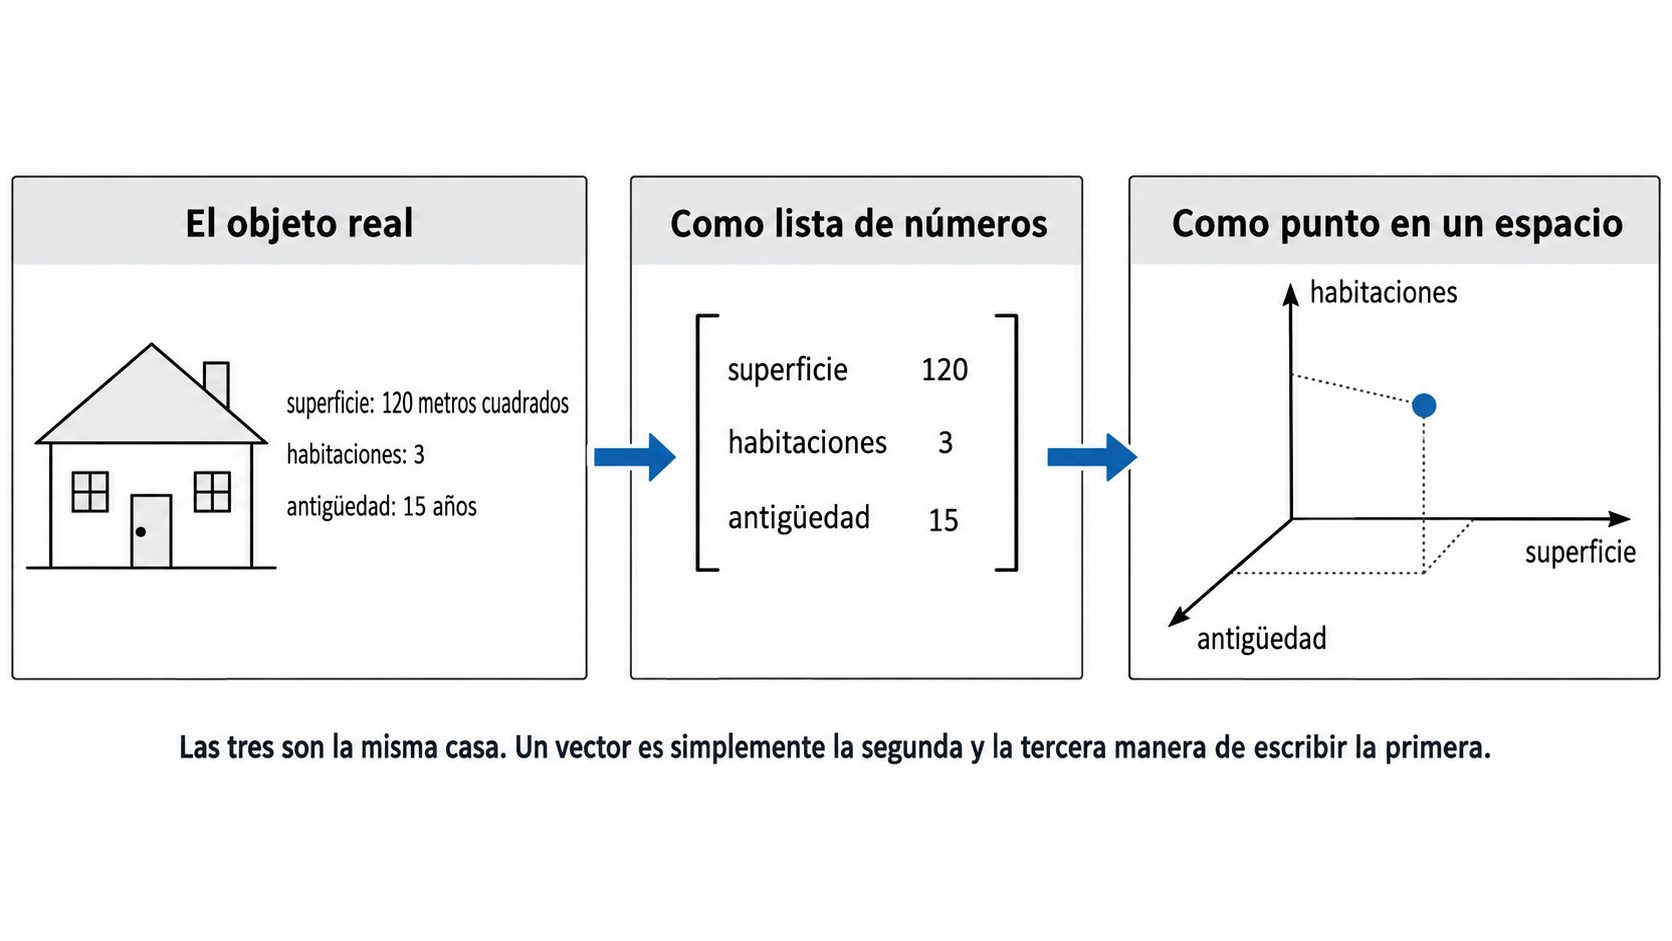
Figura 4.1. Un dato del mundo, representado como vector. La misma casa descrita por sus tres características puede pensarse como una lista ordenada de números o como un punto ubicado en un espacio de tres dimensiones. Con más características, el espacio tiene más dimensiones y deja de ser dibujable, pero la idea no cambia.
Sobre estos vectores se pueden definir operaciones matemáticas precisas. Dos vectores de la misma dimensión se pueden sumar, sencillamente sumando cada posición con la posición correspondiente del otro vector. Un vector se puede multiplicar por un número simple, llamado escalar, multiplicando cada una de sus posiciones por ese número. Y dos vectores se pueden combinar mediante una operación llamada producto interno o producto punto, que consiste en multiplicar cada posición de un vector por la posición correspondiente del otro vector, y sumar todos esos productos parciales en un único número final. Esta última operación merece que nos detengamos en ella, porque es, sin exagerar, la operación más frecuente de todo este libro: es, literalmente, lo que calcula cada una de las neuronas artificiales que se describirán en la segunda parte de este libro, y es también la operación con la que se mide, más adelante en este mismo capítulo, cuán parecidas son dos representaciones numéricas entre sí.
Conviene señalar aquí una advertencia que la intuición cotidiana sobre el espacio no anticipa, y que resulta indispensable para trabajar con los vectores de miles de dimensiones que describen palabras o imágenes. La intuición geométrica que cualquier persona desarrolla en un espacio de dos o tres dimensiones —la noción de distancia entre dos puntos como la longitud de la línea recta que los une— deja de comportarse de la manera esperada a medida que la cantidad de dimensiones crece. En espacios de muchas dimensiones aparece un fenómeno que se conoce como la maldición de la dimensionalidad, y que conviene enunciar con sus condiciones a la vista. El resultado que suele citarse dice lo siguiente: si se generan puntos al azar de modo que sus coordenadas sean independientes entre sí y sigan todas la misma distribución, y se miden las distancias entre ellos con la noción habitual de distancia en línea recta, entonces, a medida que la cantidad de dimensiones crece, la diferencia entre la distancia más grande y la más pequeña del conjunto se vuelve despreciable frente a la distancia típica. Dicho de otro modo: todos los puntos terminan quedando a distancias casi iguales entre sí, y las nociones de “cerca” y “lejos” pierden buena parte de su capacidad de distinguir un caso de otro.
Las tres condiciones subrayadas importan, y conviene no olvidarlas. Los datos reales rara vez tienen coordenadas independientes —las características de una imagen o de un texto están fuertemente correlacionadas entre sí—, y esa estructura hace que muchos conjuntos de datos ocupen, en la práctica, una región de dimensión efectiva mucho menor que la del espacio en el que están escritos. Por eso el fenómeno es más una advertencia sobre lo que puede ocurrir en el caso peor que una descripción de lo que ocurre siempre.
En los espacios de alta dimensión que maneja el aprendizaje automático moderno se usa con mucha frecuencia una medida derivada del producto interno que se acaba de definir, llamada similitud coseno: en lugar de medir la distancia entre dos vectores, mide el ángulo que forman entre sí, dividiendo su producto interno por el producto de sus longitudes individuales, de modo que el resultado depende únicamente de hacia dónde apunta cada vector y no de qué tan largo es. La razón práctica de esta preferencia es directa: al ignorar la magnitud, el coseno compara representaciones sin que las diferencias de escala entre ellas contaminen el resultado, que es exactamente el problema señalado en el recuadro anterior. Conviene no atribuirle más de lo que hace: descartar la magnitud no inmuniza contra la concentración de distancias descrita más arriba, y bajo ciertas distribuciones los ángulos también se concentran. Con esa salvedad, es la medida de similitud que se usa de manera constante para comparar representaciones de palabras, y la que reaparecerá en el capítulo 8 al presentar el mecanismo de atención.
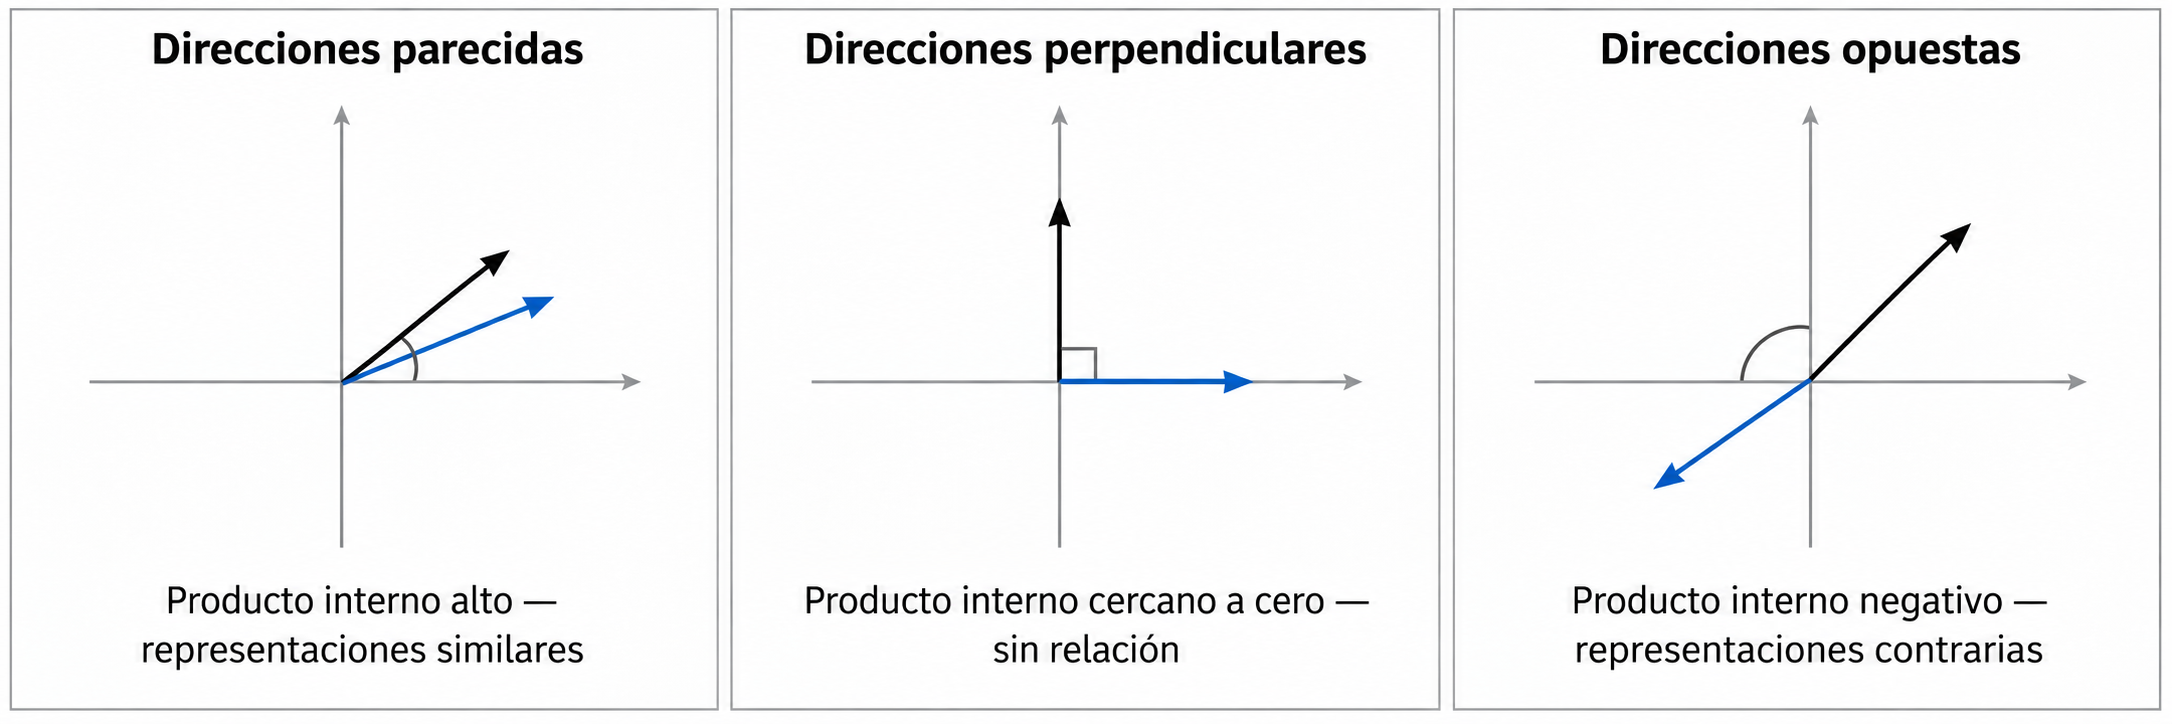
Figura 4.2. El producto interno depende del ángulo entre dos vectores, y también de sus magnitudes; normalizado por estas últimas, mide únicamente cuánto coinciden en dirección. Esta operación es la base de toda comparación entre representaciones numéricas en los sistemas que este libro describe, incluido el mecanismo de atención del capítulo 8.
Cuando se necesita transformar un vector en otro vector distinto —por ejemplo, para convertir la representación cruda de una imagen en una representación más útil que resalte sus bordes— se usa un objeto matemático llamado matriz, que en una primera aproximación se puede describir como una tabla rectangular de números organizada en filas y en columnas. Pero esta descripción, aunque correcta, oculta lo más importante: una matriz no es simplemente un contenedor de datos, sino una operación geométrica. Multiplicar un vector por una matriz no solo produce otro vector calculado mediante productos internos fila por fila: produce un vector que resulta de deformar, rotar, escalar o proyectar el espacio en el que vivía el vector original, transportándolo hacia un espacio de salida que puede tener, incluso, una cantidad distinta de dimensiones. Pensar una matriz como una transformación del espacio, y no solamente como una tabla de números, es lo que permite entender, más adelante en este libro, por qué encadenar varias capas de una red neuronal —cada una definida por su propia matriz— equivale a encadenar varias deformaciones sucesivas del espacio de representación de los datos, hasta llegar a una forma en la que el problema que el modelo busca resolver se vuelve mucho más fácil de resolver que en la representación original. Esta operación —multiplicar un vector por una matriz para obtener otro vector, entendida ahora como una transformación geométrica y no solo como una cuenta— es, en su forma más desnuda y sin ningún adorno adicional, lo que hace cada una de las capas de una red neuronal que se presentará en la segunda parte de este libro: recibe un vector de entrada, lo transforma mediante una matriz de números ajustables llamados pesos, y produce un vector de salida de una dimensión posiblemente distinta a la de entrada.
Cálculo diferencial: cómo se sabe en qué dirección corregir un error
Sección titulada «Cálculo diferencial: cómo se sabe en qué dirección corregir un error»El segundo bloque de herramientas matemáticas que este libro necesita responde a una pregunta distinta: dado que un sistema comete un error medible —el capítulo anterior de este libro llamó a esa medida el riesgo empírico—, ¿cómo sabe el sistema en qué dirección debe ajustar sus propios parámetros internos para reducir ese error, en lugar de aumentarlo por accidente?
La herramienta que responde a esta pregunta se llama derivada, y antes de definirla formalmente conviene entender, en un lenguaje completamente cotidiano, qué problema resuelve. Si una función matemática describe cómo cambia una cantidad —por ejemplo, el error de un modelo— a medida que se modifica otra cantidad —por ejemplo, el valor de uno de sus parámetros—, la derivada de esa función, evaluada en un punto concreto, indica dos cosas al mismo tiempo: si en ese punto la cantidad está aumentando o disminuyendo a medida que se incrementa el parámetro, y con qué rapidez lo está haciendo. Formalmente, la derivada se define como el límite de la razón entre el cambio producido en la función y el cambio provocado en la variable, cuando ese cambio provocado se hace cada vez más pequeño, acercándose a cero sin llegar nunca a serlo exactamente.
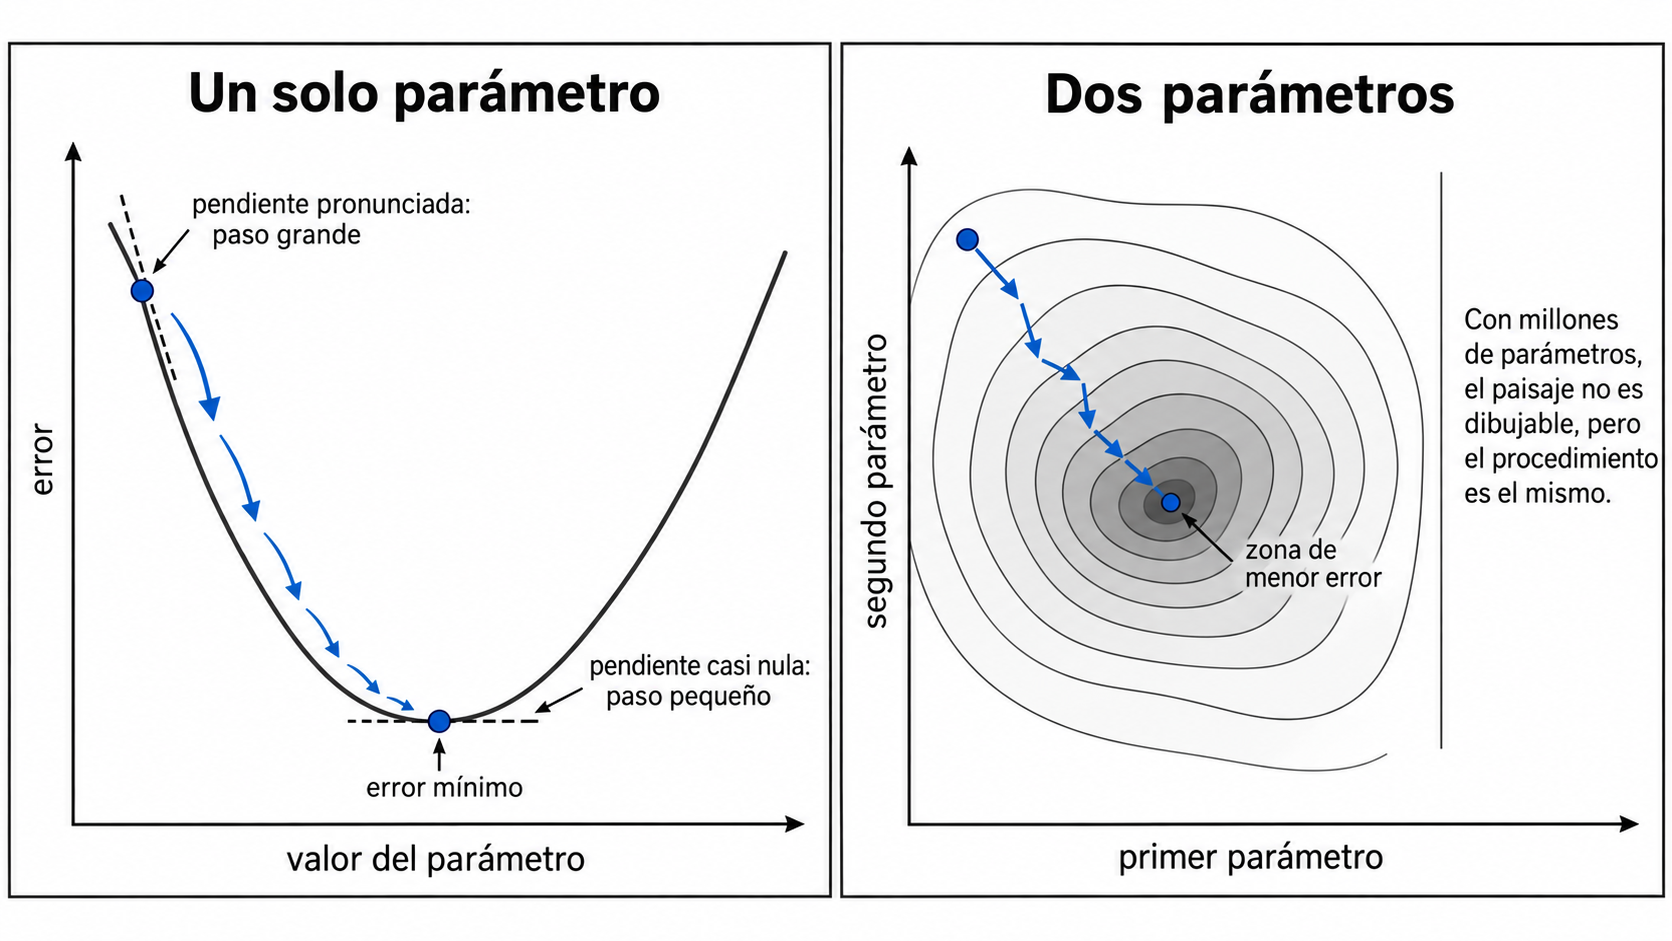
Figura 4.3. Entrenar un modelo es descender por un paisaje de error. En cada punto, la pendiente indica en qué dirección moverse y qué tan grande puede ser el paso; el procedimiento se repite hasta llegar a una zona baja. Este mecanismo, llamado descenso de gradiente, es el que ajusta los parámetros de prácticamente todos los sistemas descritos en este libro.
Cuando un modelo tiene, no un único parámetro ajustable, sino muchos —una red neuronal moderna puede tener miles de millones—, la generalización de la derivada a esta situación se llama gradiente, y consiste, simplemente, en calcular la derivada del error respecto de cada uno de esos parámetros por separado, y agrupar todas esas derivadas parciales en un único vector, de la misma dimensión que el vector de parámetros del modelo. El procedimiento de ajuste es idéntico en su lógica al del ejemplo de un solo parámetro: se mueve todo el vector de parámetros en la dirección opuesta a la que indica el vector gradiente, un paso pequeño a la vez, repitiendo el proceso una gran cantidad de veces. El algoritmo de retropropagación, mencionado ya en el capítulo dedicado a la historia de la inteligencia artificial y que se explicará con todo detalle en el capítulo dedicado a redes neuronales, no es más que un método eficiente para calcular ese gradiente completo, con todas sus componentes, en una red compuesta por muchas capas encadenadas.
Probabilidad: cómo se razona con rigor sobre lo que no se sabe con certeza
Sección titulada «Probabilidad: cómo se razona con rigor sobre lo que no se sabe con certeza»El tercer bloque de herramientas matemáticas de este capítulo responde a la pregunta que quedó abierta al final del capítulo anterior de este libro: si la inducción, según mostró el argumento de Hume, nunca ofrece certeza absoluta, ¿con qué lenguaje matemático se puede razonar, de todos modos, con la máxima precisión posible sobre esa incertidumbre irreductible?
Ese lenguaje es la teoría de la probabilidad. Una variable aleatoria es, en términos simples, una cantidad cuyo valor no se conoce de antemano con certeza, pero sobre la cual sí se puede describir qué tan probable es cada uno de sus valores posibles. Esa descripción completa —qué probabilidad tiene cada valor posible— se llama distribución de probabilidad. Cuando el resultado de tirar una moneda justa se describe como una variable aleatoria con dos valores posibles, cara y ceca, cada uno con una probabilidad de un medio, se está usando exactamente el mismo lenguaje formal que Claude Shannon utilizó, según se explicó en el primer capítulo de este libro, para calcular la entropía de esa fuente de información.
Dos ideas adicionales de la teoría de la probabilidad resultan indispensables para todo lo que sigue en este libro. La primera es la probabilidad condicional, que mide qué tan probable es un resultado, dado que ya se sabe con certeza que ocurrió otro resultado relacionado. Por ejemplo, la probabilidad de que llueva mañana no es la misma si ya se sabe que el cielo está completamente nublado hoy que si no se tiene ninguna información sobre el estado del cielo; la probabilidad condicional formaliza precisamente ese ajuste de creencias frente a nueva información. La segunda idea, que se deriva directamente de la anterior mediante un resultado conocido como el teorema de Bayes, establece una manera precisa de invertir una probabilidad condicional: permite calcular qué tan probable es una causa, dado que se observó un efecto, a partir de qué tan probable es ese efecto, dado que se conoce esa causa, combinado con qué tan probable era esa causa antes de observar nada. Este resultado es, en el fondo, la formalización matemática exacta de un tipo de razonamiento que los seres humanos hacen constantemente de manera intuitiva y con frecuencia poco rigurosa: actualizar una creencia sobre una causa posible a la luz de una nueva evidencia observada.
Una última cantidad de la teoría de la probabilidad, llamada valor esperado o esperanza matemática, resulta indispensable para conectar todo este capítulo con el marco de la minimización del riesgo empírico presentado en el capítulo anterior. El valor esperado de una variable aleatoria es el promedio de todos sus valores posibles, ponderado por la probabilidad de cada uno: es, en cierto sentido, el mejor resumen de un único número que se puede dar sobre una cantidad incierta, si se repitiera el experimento que la genera una gran cantidad de veces. Cuando el capítulo anterior de este libro definió el riesgo real de un modelo como el error promedio sobre toda la distribución posible de datos, esa definición era, precisamente, el valor esperado del error, calculado sobre la variable aleatoria que representa un dato cualquiera extraído de esa distribución. El riesgo real es, en otras palabras, una esperanza matemática; y el riesgo empírico, calculado sobre los datos de entrenamiento disponibles, es la aproximación práctica de esa esperanza que se puede calcular sin conocer la distribución completa, exactamente de la misma manera en que el promedio de un número finito de tiradas de una moneda aproxima, sin llegar nunca a igualarla con certeza absoluta, la probabilidad teórica de un medio que define a esa moneda si es justa.
Lo que este capítulo deja establecido antes de continuar
Sección titulada «Lo que este capítulo deja establecido antes de continuar»Con las tres herramientas presentadas en este capítulo, el lector cuenta ahora con el lenguaje matemático completo que hacía falta para pasar, en la segunda parte de este libro, de la descripción conceptual del aprendizaje automático a su formulación precisa y verificable. El álgebra lineal permite representar cualquier dato del mundo como un vector, y cualquier transformación de ese dato como una multiplicación por una matriz. El cálculo diferencial permite calcular, con el gradiente, en qué dirección exacta hay que mover los parámetros de un modelo para reducir su error, que es el mecanismo concreto detrás de la minimización del riesgo empírico presentada en el capítulo anterior. Y la teoría de la probabilidad permite expresar, con el rigor que Hume mostró indispensable y a la vez imposible de eludir, que ningún sistema de aprendizaje automático produce certezas sino estimaciones de confianza, cuantificadas mediante distribuciones, probabilidades condicionales y valores esperados.
El próximo capítulo deja, por su parte, la matemática abstracta, y examina una pregunta de naturaleza completamente distinta mientras esa misma matemática entra en funcionamiento: en qué máquina física, hecha de silicio, electricidad y calor disipado, se ejecutan realmente estas operaciones de álgebra lineal, de cálculo diferencial y de probabilidad, y por qué esa base física impuso, según ya adelantó el capítulo dedicado a la historia de la inteligencia artificial, un límite material real sobre lo que la teoría matemática permitía en principio.
Notas y referencias del capítulo
Sección titulada «Notas y referencias del capítulo»- Strang, G. (2016). Introduction to Linear Algebra. Wellesley-Cambridge Press. Referencia estándar de álgebra lineal aplicada.
- Sobre el uso del álgebra lineal en representaciones de datos de alta dimensión: Deisenroth, M. P., Faisal, A. A., & Ong, C. S. (2020). Mathematics for Machine Learning. Cambridge University Press.
- Sobre la maldición de la dimensionalidad: Bellman, R. (1961). Adaptive Control Processes: A Guided Tour. Princeton University Press. (Origen del término.) Sobre la similitud coseno en espacios de alta dimensión: Aggarwal, C. C., Hinneburg, A., & Keim, D. A. (2001). “On the Surprising Behavior of Distance Metrics in High Dimensional Space”. ICDT.
- Sobre el cálculo diferencial aplicado a la optimización de funciones de varias variables y el algoritmo de descenso de gradiente: Nocedal, J. & Wright, S. J. (2006). Numerical Optimization. Springer.
- Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). “Learning representations by back-propagating errors”. Nature, 323. (Ya citado en el capítulo dedicado a la historia de la Inteligencia Artificial; se retoma aquí como referencia del gradiente aplicado a redes de varias capas.)
- Sobre la teoría de la probabilidad y el teorema de Bayes: Jaynes, E. T. (2003). Probability Theory: The Logic of Science. Cambridge University Press.
- Bishop, C. M. (2006). Pattern Recognition and Machine Learning. Springer. Referencia estándar que integra álgebra lineal, cálculo y probabilidad en el contexto específico del aprendizaje automático.
Copyright © 2026 Carlos Dagorret — Licensed under Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International (CC BY-NC-ND 4.0)