9. Infraestructura a gran escala: entrenamiento distribuido y centros de datos
Cuando una sola máquina ya no alcanza
Sección titulada «Cuando una sola máquina ya no alcanza»El capítulo dedicado a los fundamentos de ingeniería de este libro presentó los principios físicos que sostienen a cualquier sistema de inteligencia artificial: transistores, arquitectura de von Neumann, paralelismo de las tarjetas gráficas, jerarquía de memoria y límites de energía. Todo ese capítulo, sin embargo, describió esos principios pensando, implícitamente, en una única máquina. Este capítulo, que cierra la segunda parte de este libro, examina qué ocurre cuando el modelo que se quiere entrenar —una arquitectura Transformer como la presentada en el capítulo anterior, con una cantidad de parámetros que hoy se cuenta en cientos de miles de millones— sencillamente no cabe, ni en memoria ni en capacidad de cálculo, dentro de una sola de esas máquinas, sin importar cuán bien diseñada esté.
Dos maneras distintas de repartir el trabajo entre varias máquinas
Sección titulada «Dos maneras distintas de repartir el trabajo entre varias máquinas»Cuando el entrenamiento de un modelo debe repartirse entre varias máquinas conectadas entre sí, existen, en principio, dos estrategias distintas y complementarias, y conviene distinguirlas con precisión porque resuelven problemas diferentes.
La primera estrategia, llamada paralelismo de datos, mantiene una copia completa del modelo —de todos sus parámetros, sin excepción— en cada una de las máquinas disponibles, y reparte, en cambio, los ejemplos de entrenamiento: cada máquina procesa un subconjunto distinto de los datos, calcula, mediante retropropagación, el gradiente correspondiente a ese subconjunto, tal como se explicó en el capítulo anterior de este libro, y luego todas las máquinas combinan sus gradientes individuales, típicamente promediándolos, antes de que cada una actualice su propia copia idéntica de los parámetros del modelo con ese gradiente combinado. Esta estrategia resulta natural cuando el modelo sí cabe en la memoria de una sola máquina, pero se quiere acelerar el entrenamiento procesando muchos más ejemplos por unidad de tiempo de los que una sola máquina podría procesar por sí sola.
La segunda estrategia, llamada paralelismo de modelo, resuelve un problema distinto: qué hacer cuando el modelo mismo, con todos sus parámetros, no cabe en la memoria de una sola máquina, sin importar cuántos datos se le muestren. En este caso, en lugar de repartir los datos, se reparte el propio modelo: distintas capas, o incluso distintas porciones de una misma capa, residen físicamente en máquinas distintas, y el cálculo de la salida de la red, así como el del gradiente durante la retropropagación, tiene que atravesar, en el orden correcto, todas esas máquinas, transmitiendo entre ellas los resultados intermedios que cada una produce. Los modelos de lenguaje de mayor escala que sostienen los sistemas conversacionales actuales, presentados en el capítulo anterior de este libro, requieren, en la práctica, combinar ambas estrategias a la vez: se reparte el modelo entre varios grupos de máquinas porque no cabe en una sola, y dentro de cada uno de esos grupos se aplica además paralelismo de datos para acelerar el procesamiento.
El costo de coordinar: por qué la red de interconexión importa tanto como el cómputo
Sección titulada «El costo de coordinar: por qué la red de interconexión importa tanto como el cómputo»Cualquiera de las dos estrategias descritas en el apartado anterior exige que distintas máquinas se comuniquen entre sí de manera constante durante el entrenamiento: para promediar gradientes en el paralelismo de datos, o para transmitir resultados intermedios de una capa a la siguiente en el paralelismo de modelo. Esta necesidad de comunicación introduce, a la escala de un centro de datos completo, exactamente el mismo tipo de limitación que el capítulo dedicado a los fundamentos de ingeniería de este libro ya describió dentro de una sola máquina, al distinguir la latencia del ancho de banda en el acceso a la memoria: ahora esa misma distinción se aplica a la red que conecta a las distintas máquinas entre sí, y con consecuencias todavía más severas, porque transmitir datos entre máquinas físicamente distintas es, invariablemente, mucho más lento que transmitirlos dentro de los circuitos de una única máquina.
Por esta razón, buena parte de la ingeniería involucrada en construir un centro de datos dedicado al entrenamiento de modelos de gran escala se concentra, no en las unidades de cálculo en sí mismas, sino en la red de interconexión que las une: se diseñan topologías de red específicas que minimizan la cantidad de saltos necesarios para que un dato viaje de una máquina a otra, y se desarrollan protocolos de comunicación especializados, capaces de combinar de manera eficiente los gradientes calculados por miles de máquinas simultáneamente sin que ninguna de ellas tenga que esperar, de manera ociosa, un tiempo desproporcionado a que le lleguen los resultados de las demás.
Conviene visualizar esta organización como una jerarquía de escalas físicas sucesivas, cada una construida a partir de la anterior. Una única tarjeta gráfica, del tipo presentado en el capítulo dedicado a los fundamentos de ingeniería de este libro, se combina con varias otras dentro de un mismo servidor o nodo, conectadas entre sí mediante un enlace de comunicación de muy alta velocidad y muy baja latencia, en el sentido de esos dos términos ya distinguido más arriba en este capítulo. Varios de esos servidores se agrupan, a su vez, en una estructura física llamada rack, donde la cercanía física sigue permitiendo una comunicación rápida entre sus componentes. Varios racks se conectan entre sí para formar un clúster de cómputo, ya con una red de interconexión menos veloz que la que une a las tarjetas dentro de un mismo servidor, pero todavía diseñada específicamente para minimizar la latencia entre sus componentes. Y, finalmente, uno o más clústeres, junto con toda la infraestructura de alimentación eléctrica y de refrigeración que se describe más adelante en este capítulo, componen un centro de datos completo. Esta progresión —de la tarjeta individual al servidor, del servidor al rack, del rack al clúster, y del clúster al centro de datos— explica por qué una cifra como “miles de tarjetas gráficas” no describe una simple multiplicación de máquinas idénticas trabajando de manera independiente, sino una arquitectura de varios niveles, cada uno con su propia red de interconexión, diseñada para que la coordinación descrita en el párrafo anterior sea, dentro de lo posible, eficiente en cada uno de esos niveles.
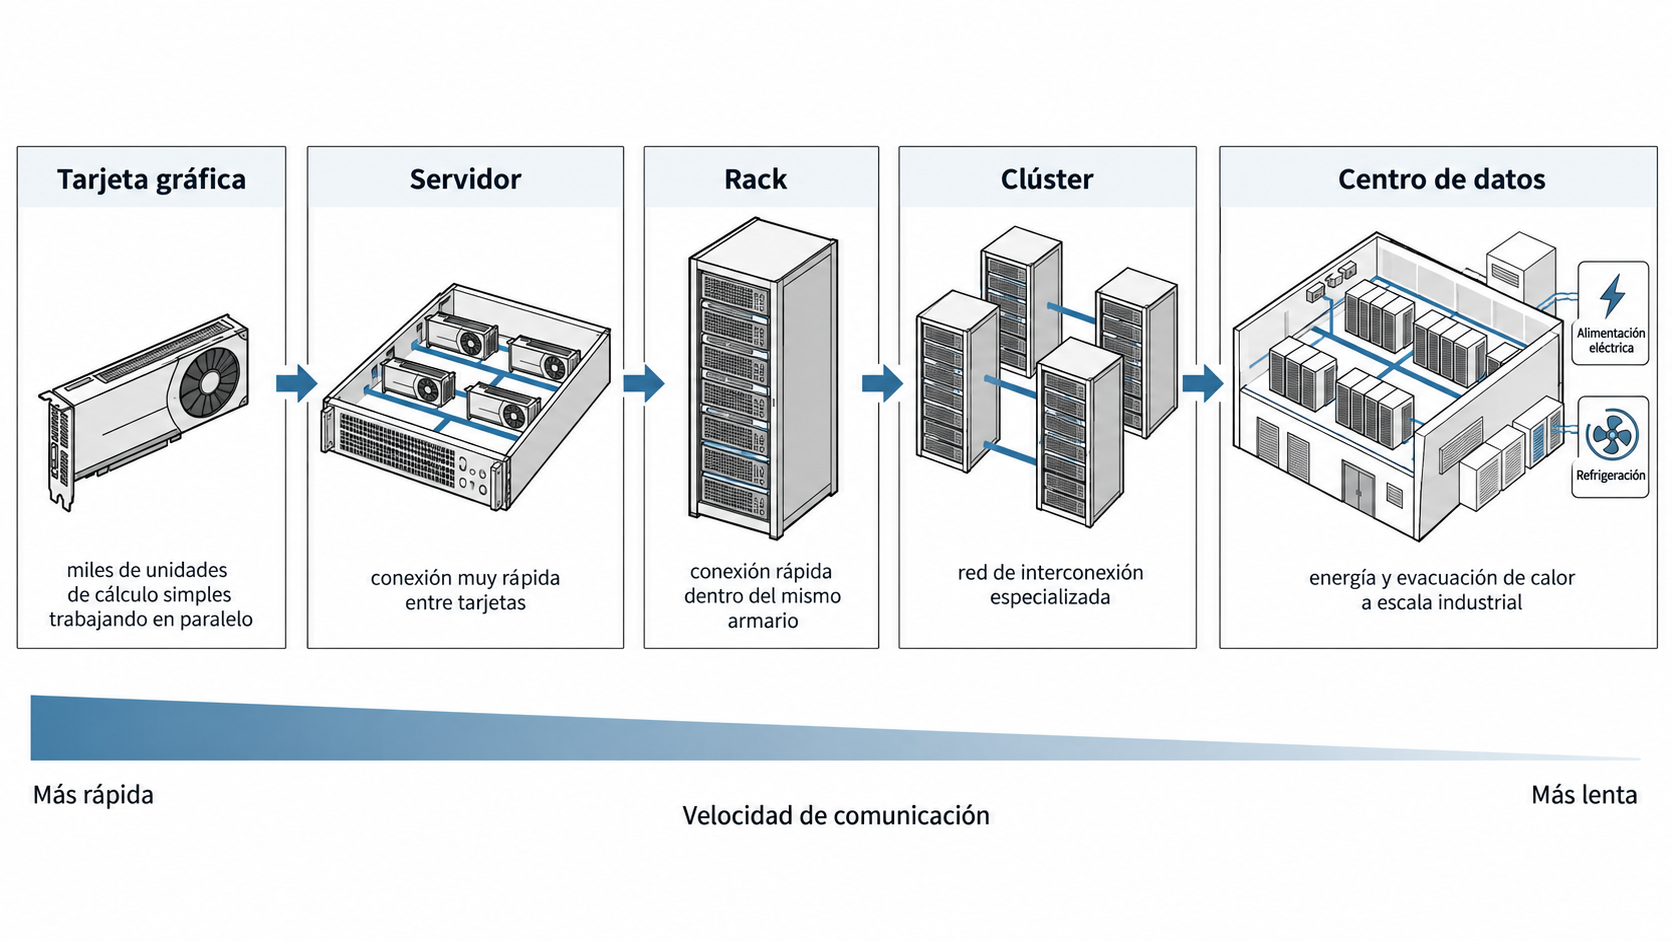
Figura 9.1. La jerarquía física del entrenamiento a gran escala. «Miles de tarjetas gráficas» no describe un conjunto de máquinas idénticas trabajando por separado, sino una arquitectura de niveles anidados donde la velocidad de comunicación disminuye a medida que se asciende de escala. Esa disminución es, en la práctica, uno de los límites principales del entrenamiento distribuido.
Cuando esta coordinación no está bien diseñada, el resultado es una versión, a la escala de todo un centro de datos, del mismo estado de “hambre de datos” que el capítulo dedicado a los fundamentos de ingeniería de este libro describió para una sola tarjeta gráfica limitada por el ancho de banda de su memoria: máquinas de cálculo extraordinariamente potentes, permaneciendo ociosas una fracción significativa del tiempo, no porque les falte capacidad de cálculo, sino porque la red que las conecta no puede entregarles ni recibir de ellas los datos con la velocidad que su capacidad de cálculo exigiría para mantenerse siempre ocupadas.
La escala física: energía, refrigeración y el costo económico del entrenamiento
Sección titulada «La escala física: energía, refrigeración y el costo económico del entrenamiento»El capítulo dedicado a los fundamentos de ingeniería de este libro ya señaló que cada operación de cómputo consume energía eléctrica que termina disipándose en forma de calor. Este capítulo puede ahora precisar esa magnitud con cifras concretas, en lugar de comparaciones vagas. Según el informe Energy and AI de la Agencia Internacional de Energía, publicado en 2025, el conjunto de los centros de datos del mundo consumió alrededor de 415 teravatios-hora de electricidad en 2024 —cerca del 1,5 por ciento del consumo eléctrico mundial total—, una cifra que la propia agencia proyecta que superará los 900 teravatios-hora hacia 2030, con los centros de datos dedicados específicamente a inteligencia artificial como el componente de crecimiento más rápido de esa cifra. A escala de una única instalación, la misma agencia señala que un centro de datos de cien megavatios de potencia instalada consume una cantidad de electricidad comparable a la de cien mil hogares, y que las instalaciones de mayor escala que se están construyendo en el momento en que se escribe este libro podrían consumir varias veces esa cantidad. Entrenar un único modelo de lenguaje de gran escala, según estimaciones independientes publicadas en 2023, puede consumir del orden de decenas de gigavatios-hora de electricidad a lo largo de todo su proceso de entrenamiento, una cantidad de energía comparable a varios días de consumo eléctrico completo de una ciudad de tamaño mediano. Conviene señalar que estas cifras cambian con rapidez, tanto porque la escala de los modelos sigue creciendo como porque la eficiencia energética por tarea realizada también mejora de manera sostenida, de modo que cualquier cifra concreta que se ofrezca aquí debe leerse como una fotografía de un momento específico y no como una constante del campo.
Entrenar uno de estos modelos exige realizar, de manera repetida a lo largo de semanas o meses de entrenamiento continuo, la operación de multiplicación de matrices presentada en el capítulo dedicado a los fundamentos matemáticos de este libro, sobre matrices cuyas dimensiones se cuentan en miles y cuyos parámetros ajustables se cuentan en cientos de miles de millones, repitiendo ese cálculo para una cantidad de ejemplos de entrenamiento que se cuenta, a su vez, en billones de fragmentos de texto. Conviene aquí una precisión terminológica que la ingeniería de cómputo distingue con cuidado. Una operación aritmética de punto flotante —una única suma o una única multiplicación entre dos números representados en el formato de precisión reducida presentado en el capítulo dedicado a los fundamentos de ingeniería de este libro— se abrevia FLOP, en singular o en plural según se hable de una operación o de una cantidad de ellas. FLOPS, en cambio, con la ese final en minúscula que en este contexto no indica plural sino la palabra “por segundo”, designa una tasa: cuántas de esas operaciones puede realizar un procesador en cada segundo, la misma clase de medida de rendimiento que el capítulo dedicado a los fundamentos de ingeniería de este libro usó, sin nombrarla así, al comparar la velocidad de una tarjeta gráfica con la de un procesador central. La cantidad total de FLOPs que exige entrenar uno de los modelos de mayor escala existentes resulta una cifra que solo tiene sentido expresar en notación científica, y completarla en un tiempo razonable exige, en consecuencia, una tasa de FLOPS agregada —la de miles de máquinas operando en paralelo, cada una consumiendo, individualmente, una cantidad de energía comparable a la de varios electrodomésticos domésticos funcionando a la vez— sostenida durante todo el tiempo que dura el entrenamiento.
Esta escala explica por qué la construcción de un centro de datos dedicado a esta tarea implica, en la práctica, decisiones de ingeniería civil tanto como de ingeniería electrónica: la ubicación geográfica de estas instalaciones responde, con frecuencia, a la disponibilidad de fuentes de energía eléctrica a gran escala y a un costo razonable, y a la posibilidad de acceder a fuentes abundantes de agua o a climas fríos que faciliten la refrigeración necesaria para evacuar el calor generado por miles de máquinas funcionando de manera continua. La reducción de precisión numérica presentada en el capítulo dedicado a los fundamentos de ingeniería de este libro, lejos de ser un detalle técnico secundario, resulta, a esta escala, una de las palancas más directas para reducir tanto el consumo energético como el costo económico total de entrenar un modelo, porque cada bit de precisión que se puede eliminar sin perder capacidad de generalización se traduce, multiplicado por la escala de miles de millones de parámetros y de miles de máquinas, en un ahorro de energía y de tiempo que ninguna otra optimización aislada podría igualar.
Lo que este capítulo deja establecido antes de continuar
Sección titulada «Lo que este capítulo deja establecido antes de continuar»Con este capítulo se completa la segunda parte de este libro. El recorrido de esta parte partió de los algoritmos más simples del aprendizaje automático clásico, avanzó hacia las redes neuronales profundas y el algoritmo de retropropagación que las hace entrenables, continuó con la arquitectura Transformer y el mecanismo de atención que sostiene a los sistemas de lenguaje actuales, y cierra ahora mostrando que ninguno de esos avances matemáticos y arquitectónicos se sostiene, en la práctica, sin una infraestructura física de una escala que la teoría matemática, por sí sola, no permite anticipar: miles de máquinas coordinadas mediante redes de interconexión cuidadosamente diseñadas, consumiendo una cantidad de energía comparable a la de ciudades enteras, y sometidas a los mismos límites de latencia, ancho de banda y disipación de calor que el capítulo dedicado a los fundamentos de ingeniería de este libro ya identificó dentro de una sola máquina, ahora multiplicados por la escala de un centro de datos completo.
La tercera parte de este libro, que comienza en el próximo capítulo, deja atrás la pregunta de cómo se construyen estos sistemas, y examina, con el mismo rigor aplicado hasta aquí, para qué se usan realmente, qué tan lejos ha llegado la investigación de frontera, y —con toda la base técnica que las dos primeras partes de este libro dejaron preparada— cuáles son sus límites verificables y qué preguntas filosóficas siguen abiertas después de haber entendido, con precisión, su funcionamiento interno.
Notas y referencias del capítulo
Sección titulada «Notas y referencias del capítulo»- Sobre las estrategias de paralelismo de datos y de modelo en el entrenamiento distribuido: Dean, J. et al. (2012). “Large Scale Distributed Deep Networks”. NeurIPS.
- Sobre el paralelismo de modelo aplicado específicamente a arquitecturas Transformer de gran escala: Shoeybi, M. et al. (2019). “Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism”. arXiv:1909.08053.
- Sobre las topologías de red de interconexión en centros de datos de cómputo de alto rendimiento: Kim, J., Dally, W. J., & Abts, D. (2008). “Technology-Driven, Highly-Scalable Dragonfly Topology”. ISCA.
- Sobre el consumo energético de los centros de datos dedicados a inteligencia artificial y su proyección a 2030: International Energy Agency (2025). Energy and AI. Informe especial.
- Sobre las estimaciones de consumo energético del entrenamiento de modelos de lenguaje de gran escala: de Vries, A. (2023). “The Growing Energy Footprint of Artificial Intelligence”. Joule, 7(10).
- Sobre el costo computacional total, medido en FLOPs, del entrenamiento de modelos de lenguaje de gran escala: Hoffmann, J. et al. (2022). “Training Compute-Optimal Large Language Models”. arXiv:2203.15556.
Copyright © 2026 Carlos Dagorret — Licencia Creative Commons Atribución-NoComercial-SinDerivadas 4.0 Internacional (CC BY-NC-ND 4.0)