2. Historia de la Inteligencia Artificial: de los primeros autómatas al presente
Antes de que existiera el nombre: autómatas, lógica formal y la pregunta de Turing
Sección titulada «Antes de que existiera el nombre: autómatas, lógica formal y la pregunta de Turing»El capítulo anterior mostró que la palabra inteligencia llegó a la informática cargada de una historia filosófica y psicológica de más de dos mil años, sin que esa historia hubiera producido nunca una definición cerrada. Este capítulo retoma el relato justo donde terminó el anterior: en el momento en que un grupo reducido de investigadores decidió, de manera pragmática, dejar de lado la pregunta filosófica y empezar a construir.
Antes de que existiera siquiera el nombre inteligencia artificial, ya existían dos tradiciones que la hicieron posible. La primera es la tradición de los autómatas: máquinas mecánicas construidas para imitar movimientos de seres vivos, como los relojes con figuras animadas del siglo dieciocho o los muñecos mecánicos capaces de escribir frases fijas mediante engranajes internos. Estos artefactos no tenían nada parecido a inteligencia en ningún sentido técnico, pero cumplieron una función cultural importante: acostumbraron a la imaginación humana a la idea de que un mecanismo podía imitar, aunque fuera de manera limitada y predeterminada, un comportamiento que hasta entonces se consideraba exclusivamente humano o animal.
La segunda tradición, mucho más decisiva, es la formalización de la lógica. Durante el siglo diecinueve, con los trabajos de George Boole sobre el álgebra de la lógica, y más tarde, a comienzos del siglo veinte, con la obra de Bertrand Russell y Alfred North Whitehead, se mostró que buena parte del razonamiento humano —al menos el razonamiento deductivo, el que va de premisas a conclusiones siguiendo reglas fijas— se podía expresar mediante símbolos y operaciones tan precisas como las de la aritmética. Esta idea resultó decisiva porque, si el razonamiento se puede reducir a manipulación de símbolos según reglas fijas, entonces en principio una máquina capaz de manipular símbolos según reglas fijas podría razonar. Esta inferencia, que hoy puede parecer evidente, no lo era en absoluto antes de que existiera la lógica formal, y es la que permitió, por primera vez, plantear la pregunta de la inteligencia de máquina en términos técnicos y no solo especulativos.
Sobre esta base trabajó el matemático británico Alan Turing, cuya contribución de 1950 conviene situar con precisión, porque suele citarse de manera imprecisa. Turing no afirmó haber resuelto el problema filosófico de si una máquina puede pensar; de hecho, consideró esa pregunta demasiado ambigua para ser útil, y propuso reemplazarla por una pregunta operativa: si un evaluador humano, comunicándose por escrito con un interlocutor oculto que puede ser una persona o una máquina, no logra distinguir de manera confiable cuál es cuál, entonces, a efectos prácticos, tiene sentido decir que la máquina exhibe un comportamiento equivalente al de un ser humano en esa tarea concreta. Esta propuesta —que hoy se conoce como el test de Turing— es, en rigor, el primer ejemplo histórico de exactamente el mismo movimiento que el capítulo anterior describió como definición de trabajo: en vez de resolver la pregunta filosófica de fondo, Turing la sustituyó por un criterio observable y verificable.
Treinta años después de la propuesta de Turing, el filósofo estadounidense John Searle publicó un argumento que ataca precisamente ese movimiento, y que sigue siendo, hoy mismo, la objeción filosófica más citada contra la idea de que superar el test de Turing equivale a pensar de verdad. Searle propuso el siguiente experimento mental, conocido desde entonces como la Habitación China. Imaginemos a una persona que no conoce ni una sola palabra de chino, encerrada en una habitación junto con un libro de reglas extenso, escrito en su propio idioma, que especifica, para cualquier combinación posible de símbolos chinos que entren por una ranura en la puerta, exactamente qué otra combinación de símbolos chinos debe devolver como respuesta, siguiendo únicamente la forma de los símbolos, sin que el libro de reglas explique en ningún momento qué significa ninguno de esos símbolos. Personas de habla china, fuera de la habitación, introducen preguntas escritas en su idioma por la ranura, y reciben, gracias a la aplicación mecánica de las reglas del libro, respuestas coherentes y apropiadas, también en chino. Desde el punto de vista de quienes están afuera, todo indica que dentro de la habitación hay alguien que entiende chino con fluidez —la habitación, en conjunto, superaría sin dificultad el test de Turing en ese idioma. Pero la persona que sigue las reglas dentro de la habitación, según el propio planteo del experimento, no ha entendido en ningún momento una sola palabra de lo que leyó ni de lo que escribió: solo manipuló símbolos según su forma, sin acceso a su significado.
La distinción que Searle quiere que el lector extraiga de este experimento tiene dos nombres técnicos que este libro va a usar de manera reiterada en los capítulos siguientes, sobre todo en el dedicado a los modelos de lenguaje. La sintaxis es el conjunto de reglas que rigen cómo se combinan y manipulan los símbolos de un sistema, sin referencia a lo que esos símbolos representan; la semántica es, precisamente, esa relación entre un símbolo y aquello que representa o significa. El argumento de Searle sostiene que un programa de computadora, sin importar cuán sofisticado sea, opera exclusivamente en el nivel de la sintaxis —manipula símbolos según reglas formales— y que ninguna cantidad de manipulación puramente sintáctica, por sí sola, puede producir semántica genuina, del mismo modo que la persona dentro de la habitación nunca llega a entender chino por más reglas que aplique correctamente.
Es importante que el lector note con precisión qué es lo que este argumento pone en duda y qué es lo que no pone en duda. No pone en duda que un sistema pueda producir un comportamiento externo indistinguible del de un hablante que sí entiende: el propio experimento concede ese punto sin discusión. Lo que pone en duda es que ese comportamiento externo, por convincente que sea, constituya evidencia suficiente de que hay comprensión genuina ocurriendo por dentro. Esta es la razón precisa por la que el argumento de Searle se dirige contra el test de Turing: si el criterio para atribuir comprensión es exclusivamente conductual —qué tan bien engaña un sistema a un evaluador—, entonces ese criterio no puede distinguir nunca entre un sistema que de verdad comprende y un sistema que simplemente ejecuta, con enorme fidelidad, un conjunto de reglas de manipulación de símbolos sin acceso a su significado.
El argumento de Searle no ha quedado sin respuesta: la réplica más conocida entre quienes lo cuestionan, llamada la respuesta de sistemas, sostiene que, aunque la persona dentro de la habitación no entienda chino, tal vez sea el sistema completo —la persona, el libro de reglas y el proceso de manipulación en su conjunto— el que sí comprende, de una manera que no se puede localizar en ninguna de sus partes por separado, de la misma forma en que ninguna neurona individual del cerebro humano entiende una palabra, aunque el cerebro completo sí lo haga. Searle respondió a su vez que la persona podría, en principio, memorizar todo el libro de reglas y prescindir por completo de la habitación física, sin que eso cambiara en nada la falta de comprensión, lo cual —según él— muestra que el problema no está en los límites físicos de la habitación sino en la naturaleza puramente sintáctica del proceso mismo. Este debate sigue abierto en la filosofía de la mente contemporánea, y este libro no pretende cerrarlo: lo que sí puede, y va a hacer con todo el rigor técnico necesario en el capítulo dedicado a los modelos de lenguaje, es mostrar con precisión matemática qué proceso ocurre exactamente por dentro de un sistema conversacional actual cuando produce una respuesta, de modo que el lector pueda evaluar por sí mismo, con conocimiento técnico completo y no solo con intuición, en qué medida ese proceso se parece o no se parece a la manipulación puramente sintáctica que describe el experimento de Searle.
El nacimiento oficial del campo: la conferencia de Dartmouth
Sección titulada «El nacimiento oficial del campo: la conferencia de Dartmouth»El nombre inteligencia artificial no existía todavía cuando Turing escribió su artículo. Conviene distinguir dos hechos que suelen confundirse. La expresión fue acuñada por el matemático John McCarthy en 1955, al redactar, junto con Marvin Minsky, Nathaniel Rochester y Claude Shannon, la propuesta de financiamiento para un encuentro de investigadores que se celebraría al año siguiente. Ese encuentro tuvo lugar efectivamente en 1956, en el Dartmouth College, en el estado de New Hampshire, y se conoce hoy como la conferencia de Dartmouth: es el acta de nacimiento institucional del campo como disciplina de investigación independiente, aunque el término que le da nombre sea un año anterior.
La propuesta que McCarthy redactó para conseguir financiamiento de esa reunión contiene una frase que merece citarse porque resume, con una claridad notable, el programa completo que la disciplina se propuso desde su primer día: la conjetura de que todo aspecto del aprendizaje o cualquier otra característica de la inteligencia puede, en principio, describirse con precisión suficiente como para construir una máquina que lo simule. Nótese la expresión “en principio”: los firmantes de esta propuesta no afirmaban tener ya el conocimiento necesario para construir esa máquina, sino que apostaban a que ese conocimiento existía y podía llegar a formalizarse, apuesta que, setenta años después, sigue sin haberse confirmado ni refutado de manera concluyente, y que sigue siendo, en el fondo, la misma apuesta sobre la que trabaja toda investigación actual en el campo.
Durante los años siguientes a esta conferencia, entre finales de la década de 1950 y comienzos de la de 1970, el optimismo entre los investigadores del campo fue extraordinario, y hoy resulta instructivo revisar algunas de sus predicciones más célebres, no para burlarse de ellas en retrospectiva sino para entender un patrón que se va a repetir más de una vez en esta historia: el propio Marvin Minsky llegó a pronosticar que, en el plazo de una generación, los problemas de crear inteligencia artificial estarían sustancialmente resueltos. Ese optimismo se apoyaba en éxitos reales pero limitados: programas capaces de demostrar teoremas simples de geometría, de jugar juegos de mesa sencillos, o de resolver problemas de álgebra expresados en lenguaje natural muy restringido. El error, que solo se hizo evidente con el paso de los años, fue extrapolar el ritmo de esos primeros progresos, obtenidos en dominios deliberadamente simplificados, hacia problemas del mundo real que resultarían muchísimo más difíciles de lo previsto, en particular la percepción visual y la comprensión del lenguaje natural sin restricciones.
Dos escuelas en disputa: el paradigma simbólico y el paradigma conexionista
Sección titulada «Dos escuelas en disputa: el paradigma simbólico y el paradigma conexionista»Antes de continuar con el relato cronológico, conviene detenerse a nombrar con precisión algo que, hasta aquí, este capítulo solo dejó entrever: la historia que sigue no es una simple sucesión de fechas y avances técnicos, sino la crónica de un desacuerdo persistente entre dos escuelas de pensamiento que discreparon, durante más de medio siglo, sobre los supuestos más básicos de qué es la cognición y cómo debe reproducirse en una máquina. Entender esta historia como una disputa entre dos paradigmas, y no como una lista de hitos, es lo que permite ver por qué cada invierno de la inteligencia artificial no fue un simple tropiezo técnico, sino la derrota temporal de una de las dos escuelas frente a la otra.
La primera escuela, dominante desde la propia conferencia de Dartmouth hasta fines de la década de 1980, es la que este libro ya viene llamando el paradigma simbólico. Su premisa de partida es que la inteligencia consiste en la capacidad de manipular símbolos discretos —representaciones explícitas de conceptos, como “gato” o “más grande que”— mediante reglas lógicas igualmente explícitas. Se lo describe como un enfoque de arriba hacia abajo porque exige que un experto humano extraiga primero el conocimiento sobre un dominio del mundo, lo traduzca a un conjunto de axiomas, y lo codifique manualmente en un sistema formal antes de que la máquina pueda operar con él; la máquina no descubre las reglas, las recibe ya hechas. Su sustrato matemático es el que ya se presentó en el capítulo anterior de este libro: la lógica de primer orden, el álgebra booleana, los árboles de decisión y los grafos de búsqueda.
Esta escuela encontró su formulación más ambiciosa en un principio propuesto por los investigadores Allen Newell y Herbert Simon, conocido como la hipótesis del sistema de símbolos físicos, que sostiene que la capacidad de manipular símbolos discretos según reglas formales es, al mismo tiempo, condición necesaria y condición suficiente para la acción inteligente en general. Es difícil exagerar el peso de esta afirmación: no dice solamente que la manipulación simbólica puede producir comportamiento inteligente en algunos casos, sino que es la única vía posible hacia la inteligencia general, sea esta llevada a cabo por un cerebro biológico o por una máquina. El paradigma simbólico resultó explicable, transparente, y deductivamente riguroso en entornos cerrados y bien acotados, como el ajedrez o la demostración de teoremas; pero, como este mismo capítulo mostrará en detalle, resultó sumamente frágil frente a la ambigüedad, el ruido perceptivo y la información no estructurada que caracteriza al mundo real fuera de esos entornos cerrados.
La segunda escuela, que convivió con la primera desde 1957 pero que permaneció marginada durante buena parte de las tres décadas siguientes, es el paradigma conexionista, que este libro ya presentó de manera general en el capítulo anterior bajo el nombre más amplio de aprendizaje automático y aprendizaje profundo. Su premisa de partida es la contraria a la del paradigma simbólico: sostiene que intentar codificar el pensamiento mediante reglas lógicas explícitas es, de entrada, un error de método, y que la inteligencia no se programa desde afuera sino que emerge de la interacción de un número muy grande de unidades de procesamiento numérico simples, organizadas en red e inspiradas de manera laxa en el funcionamiento de las neuronas biológicas. Se lo describe como un enfoque de abajo hacia arriba porque no requiere que ningún humano programe las reglas de un dominio particular: el sistema recibe datos crudos y ajusta, de manera autónoma y guiada únicamente por la experiencia acumulada, los valores numéricos de las conexiones entre sus unidades internas. Su sustrato matemático —el álgebra lineal, el cálculo diferencial de varias variables y la estadística probabilística que se desarrollarán con todo detalle en el capítulo dedicado a los fundamentos matemáticos de este libro— es enteramente distinto del de la escuela simbólica.
La hipótesis central del conexionismo también es la contraria a la de Newell y Simon: el conocimiento que posee un sistema de este tipo no está localizado en ningún símbolo identificable ni en ninguna regla explícita que se pueda leer y comprender de manera aislada, sino que está distribuido entre los pesos numéricos de todas las conexiones de la red, de modo que ninguna conexión individual “sabe” nada por sí sola, del mismo modo en que ninguna neurona aislada del cerebro humano contiene, por sí misma, el significado de una palabra. Esta manera de representar el conocimiento resultó extremadamente robusta frente al ruido y muy adecuada para tareas de percepción —visión, audio, lenguaje natural— y mostró, además, una notable capacidad de generalizar inductivamente más allá de los ejemplos vistos durante el entrenamiento. Pero tuvo, y sigue teniendo, dos debilidades serias que este libro retomará en capítulos posteriores: resulta opaca desde el punto de vista lógico, porque no es posible, en general, leer en los pesos de una red entrenada una explicación humanamente comprensible de por qué produjo una decisión particular —un problema que se conoce en la literatura del campo como el problema de la caja negra—, y resulta, además, computacionalmente mucho más costosa de entrenar que un sistema de reglas simbólicas equivalente.
Con estas dos escuelas ya definidas, el resto de este capítulo puede leerse a la luz de la tensión entre ambas: no como una progresión lineal de avances técnicos, sino como una alternancia en la que cada una dominó el financiamiento, la agenda académica y hasta el diseño del hardware durante distintos períodos, y en la que el declive de una no significó nunca su desaparición, sino su repliegue a la espera de las condiciones que le permitieran resurgir.
Conviene advertir, sin embargo, que esta lente tiene un costo. Presentar setenta años de historia como el enfrentamiento de dos bandos es una simplificación útil para orientarse, pero deja fuera tradiciones que no encajan cómodamente en ninguno de los dos: la estadística bayesiana, la cibernética que este libro ya mencionó al hablar de Wiener, la computación evolutiva, el aprendizaje por refuerzo, los métodos de núcleo que dominaron los años noventa, y toda una franja de trabajos híbridos que combinaron representaciones simbólicas con aprendizaje estadístico. Muchos investigadores nunca se reconocieron en ninguno de los dos bandos. Este libro usa la distinción entre lo simbólico y lo conexionista porque ordena el relato y porque los propios protagonistas la usaron en sus disputas por el financiamiento, no porque agote la historia real del campo.
El primer invierno y las limitaciones del perceptrón
Sección titulada «El primer invierno y las limitaciones del perceptrón»La primera fase de esta disputa fue de dominio simbólico casi absoluto, y su episodio decisivo tiene nombre y fecha precisos. En paralelo a la línea de investigación basada en lógica y símbolos que predominaba en Dartmouth, existía desde 1957 una línea distinta, inspirada más directamente en el funcionamiento de las neuronas biológicas: el germen temprano de lo que este capítulo acaba de presentar como el paradigma conexionista. El psicólogo e ingeniero Frank Rosenblatt había construido un modelo llamado perceptrón, capaz de ajustar automáticamente sus propios parámetros internos a partir de ejemplos, en lugar de recibir reglas escritas a mano. Esta idea es, en su estructura más profunda, un antecesor directo de todo lo que hoy se llama aprendizaje automático, y el hecho de que ya existiera en 1957 muestra algo que este libro va a subrayar repetidamente: las ideas centrales del aprendizaje a partir de datos no son nuevas; lo que ha cambiado, como se explicará en detalle más adelante, son las condiciones materiales que permiten llevarlas a la práctica a gran escala.
En 1969, Marvin Minsky, uno de los organizadores de la conferencia de Dartmouth, publicó junto con Seymour Papert un libro titulado Perceptrons, que demostraba con rigor matemático que el modelo de Rosenblatt tenía limitaciones muy serias. El ejemplo que hizo célebre a este libro, y que conviene desarrollar aquí con el detalle matemático que merece porque ilustra con total claridad la diferencia entre una limitación superable con más datos y una limitación estructural, es el llamado problema de la disyunción exclusiva, conocido habitualmente por su sigla en inglés, XOR.
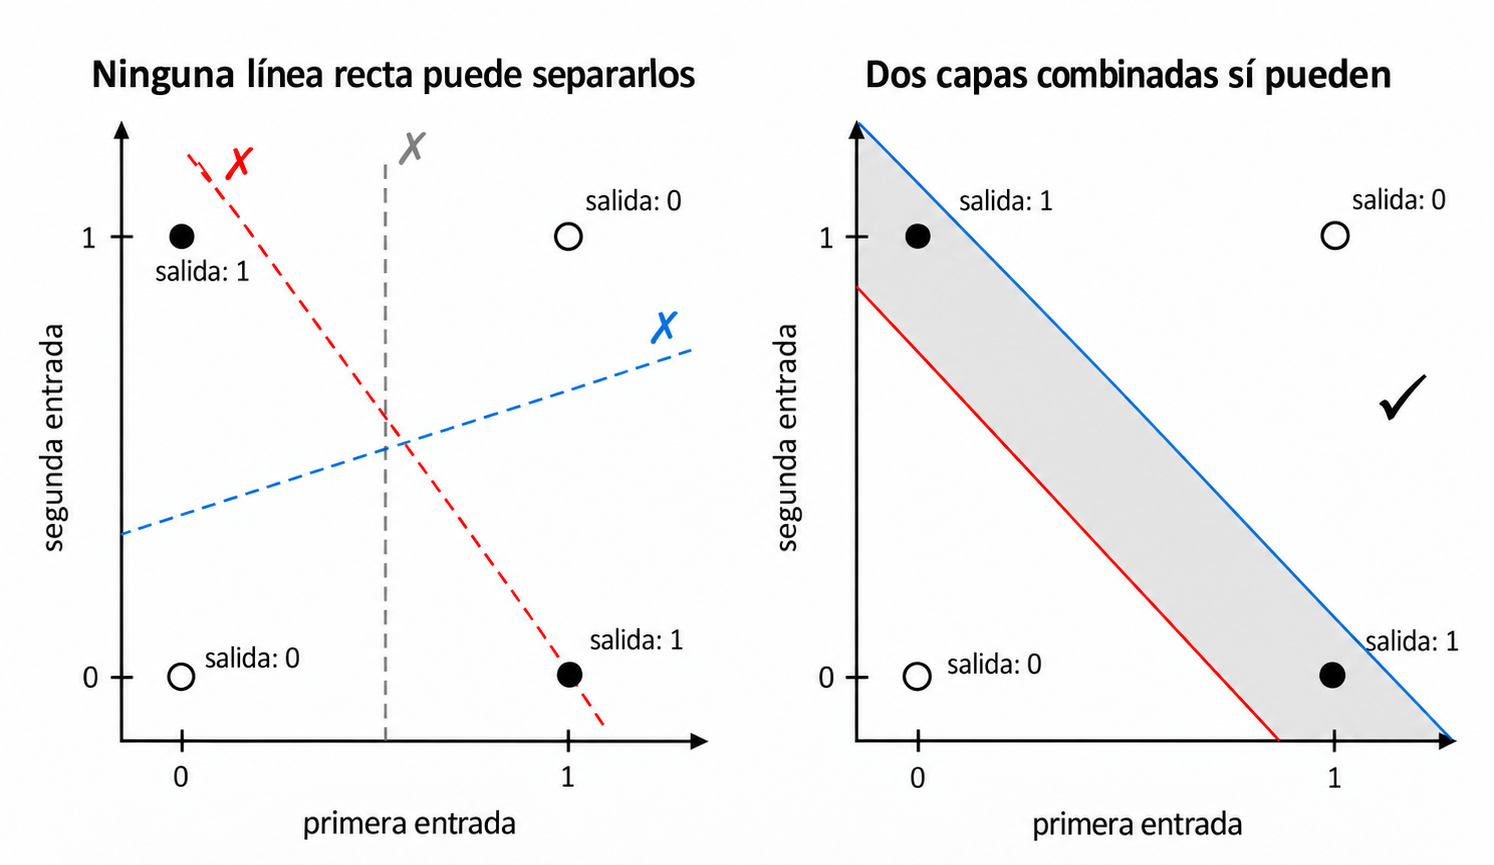
Figura 2.1. El problema de la disyunción exclusiva. Los dos casos que deben producir salida 1 quedan en esquinas opuestas del cuadrado, y los dos que deben producir 0 en las otras dos: ninguna línea recta puede separar ambos grupos, sin importar cómo se ajusten sus parámetros. Combinar dos capas sí produce una frontera capaz de resolverlo.
Lo que ocurrió después es objeto de una discusión historiográfica que conviene no zanjar de manera apresurada. Es un hecho documentado que la financiación y el interés de la comunidad investigadora hacia los modelos inspirados en redes neuronales decayeron marcadamente durante las dos décadas siguientes. Lo discutido es la relación causal: una interpretación muy difundida, recogida entre otros lugares en la Stanford Encyclopedia of Philosophy, atribuye a este libro una influencia decisiva en esa caída. Otros historiadores del campo la relativizan; Nils Nilsson, que fue además protagonista directo de esos años, dejó constancia de sus dudas sobre esa explicación, señalando que el desplazamiento de la atención investigadora hacia la programación heurística ya estaba en marcha antes de 1969. Este libro adopta la primera lectura porque ordena el relato, pero la señala como interpretación histórica y no como hecho establecido. Conviene ser preciso sobre qué fue exactamente lo que quedó paralizado durante esas dos décadas, porque no fue la idea de apilar varias capas —esa solución ya se conocía en teoría, como el propio recuadro anterior explicó— sino la ausencia de un algoritmo de optimización capaz de ajustar, de manera eficiente y automática, los pesos de todas esas capas a la vez. Sin ese algoritmo, construir una red de varias capas era, en la práctica, casi tan inútil como no tener la idea: se sabía qué arquitectura hacía falta, pero no había manera práctica de entrenarla. Esa parálisis se extendió, de manera casi literal, hasta que el algoritmo de retropropagación se popularizó y se masificó en 1986, según se explica más adelante en este mismo capítulo. La escuela simbólica, ya dominante desde Dartmouth, usó esta demostración —más allá de lo que sus propios autores pretendían literalmente— para asfixiar casi por completo el financiamiento del paradigma conexionista durante la década de 1970, consolidando así el predominio simbólico de las dos décadas siguientes. Este episodio, junto con otro similar ocurrido a mediados de la década de 1970 —cuando informes gubernamentales encargados en el Reino Unido y en Estados Unidos para evaluar los avances reales del campo concluyeron que los resultados obtenidos hasta entonces no justificaban las expectativas generadas, lo cual produjo recortes de financiamiento severos en ambos países— dio origen a una expresión que la propia comunidad de investigadores adoptó para describir estos períodos: los inviernos de la inteligencia artificial, momentos en los que el entusiasmo inicial por una línea de investigación choca con sus limitaciones reales, el financiamiento se retira, y el trabajo continúa, si es que continúa, de manera mucho más restringida y con muchísima menor visibilidad pública.
Vale la pena que el lector retenga este patrón, porque no fue un episodio aislado: se va a repetir, con variaciones, más adelante en este mismo capítulo, y entenderlo ayuda a mantener una actitud apropiadamente cautelosa frente a los anuncios más entusiastas que rodean al campo en cualquier época, incluida la actual.
El resurgimiento simbólico: los sistemas expertos
Sección titulada «El resurgimiento simbólico: los sistemas expertos»Tras el primer invierno, el campo no desapareció: la escuela simbólica, todavía dominante, se reorientó. Durante la década de 1970 y buena parte de la de 1980, la investigación dominante volvió a concentrarse en el enfoque simbólico que el capítulo anterior ya presentó de manera general: sistemas que representan el conocimiento mediante reglas lógicas explícitas, escritas a mano por especialistas humanos en un dominio particular. Estos sistemas recibieron el nombre de sistemas expertos, porque intentaban capturar, en forma de reglas, el conocimiento de un experto humano en un campo restringido, como el diagnóstico de infecciones bacterianas o la configuración de componentes de computadoras industriales.
Los sistemas expertos tuvieron, durante un tiempo, éxitos comerciales genuinos, y esto produjo un segundo período de entusiasmo y de inversión sostenida, incluyendo un ambicioso programa de investigación financiado por el gobierno japonés a comienzos de la década de 1980, conocido como el proyecto de la quinta generación de computadoras, que buscaba construir máquinas capaces de razonamiento simbólico avanzado y de procesamiento masivamente paralelo.
Conviene examinar con más detenimiento por qué colapsó este segundo período de entusiasmo, porque la explicación habitual —que la investigación simplemente “se quedó sin ideas”— es imprecisa y oculta una lección de ingeniería y de economía que este libro quiere dejar establecida con toda claridad. El mismo problema estructural que ya se había señalado al describir las debilidades del paradigma simbólico —que el conocimiento humano experto resultó mucho más difícil de capturar por completo en reglas explícitas de lo que se había anticipado— tuvo, además, una consecuencia material concreta y verificable en el mercado de hardware de la época.
Para ejecutar de manera eficiente el lenguaje de programación llamado Lisp, en el que estaban escritos la mayoría de los sistemas expertos, empresas como Symbolics y Lisp Machines Incorporated diseñaron y vendieron durante la primera mitad de la década de 1980 computadoras especializadas, conocidas como máquinas Lisp, con arquitecturas de hardware construidas específicamente para ese lenguaje y que llegaban a costar decenas de miles de dólares por unidad. Estas máquinas resolvían, mediante hardware dedicado y costoso, un problema que las computadoras de propósito general de la época no podían resolver con suficiente velocidad: la gestión eficiente de la memoria y de las estructuras de datos simbólicas que requerían los programas de razonamiento lógico. Es decir, la limitación no era solamente conceptual —qué tan bien se podía capturar el conocimiento experto en reglas— sino directamente física: la memoria disponible y la capacidad de cómputo de la época imponían un techo real sobre qué tan grande y qué tan rápido podía llegar a ser un sistema experto antes de volverse impracticablemente lento o costoso.
Hacia 1987, ese mercado de hardware especializado colapsó de manera abrupta y verificable en las cifras de ventas de la época, cuando computadoras de propósito general fabricadas por empresas como IBM y Apple, mucho más baratas y de uso mucho más general, alcanzaron una capacidad de cómputo suficiente para ejecutar tareas simbólicas razonablemente bien sin necesidad de hardware dedicado, eliminando de un golpe la ventaja competitiva que había justificado el precio de las máquinas Lisp. La empresa Symbolics, una de las principales fabricantes de este hardware especializado, vio caer sus ingresos por productos de manera pronunciada y sostenida durante los años siguientes. A esto se sumó un problema de fondo que los propios sistemas expertos nunca lograron resolver de manera satisfactoria, conocido en la literatura del campo como el problema de la cualificación: cualquier conjunto de reglas, por extenso que fuera, se topaba tarde o temprano con una situación excepcional no contemplada por sus autores, y añadir una regla nueva para cubrir esa excepción con frecuencia generaba, a su vez, nuevas excepciones no previstas.
La lección que este episodio deja, y que este libro quiere subrayar con toda la fuerza posible como advertencia permanente contra el optimismo desmedido, es la siguiente: los sistemas expertos no colapsaron porque a sus creadores se les hubieran agotado las ideas sobre cómo representar el conocimiento humano, sino porque venderon la promesa de un razonamiento de nivel humano en un momento en el que ni la memoria física disponible ni la capacidad de cómputo existente podían sostener esa promesa a un costo económicamente viable, y porque el problema conceptual de la cualificación resultó, además, mucho más profundo de lo previsto. El límite del enfoque deductivo quedó así demostrado en la práctica y no solo en la teoría: el conocimiento humano cotidiano resultó demasiado vasto, y demasiado implícito, para codificarse a mano en su totalidad. Hacia fines de la década de 1980, con el mantenimiento de estos sistemas vuelto costoso, su rendimiento estancado, y su mercado de hardware especializado desplomado, se produjo un segundo invierno de la inteligencia artificial —esta vez el repliegue recayó sobre la escuela simbólica que hasta entonces había dominado el campo—, con una nueva caída pronunciada del financiamiento y del interés público, que se extendió durante buena parte de la primera mitad de la década de 1990.
El regreso silencioso de las redes neuronales y el giro hacia la estadística
Sección titulada «El regreso silencioso de las redes neuronales y el giro hacia la estadística»Mientras los sistemas expertos dominaban la atención pública, un grupo más reducido de investigadores continuó trabajando, con menos recursos y menos visibilidad, sobre el problema que Minsky y Papert habían dejado abierto en 1969: cómo ajustar los parámetros de una red de varias capas de manera práctica. La solución se llama retropropagación del error, y su historia tiene más eslabones de los que suele contarse. El principio matemático que la sustenta —la diferenciación en modo reverso, es decir, la aplicación sistemática de la regla de la cadena para calcular derivadas hacia atrás a través de una secuencia de operaciones encadenadas— fue desarrollado en 1970 por el matemático finlandés Seppo Linnainmaa, en un contexto general de cálculo numérico y sin referencia alguna a redes neuronales. Su aplicación al entrenamiento de redes fue propuesta después: el hito que suele citarse en esa genealogía es la tesis doctoral de Paul Werbos, de 1974. El trabajo de David Rumelhart, Geoffrey Hinton y Ronald Williams, publicado en 1986, no inventó desde cero la retropropagación, pero desempeñó un papel decisivo en su demostración, su difusión y su adopción generalizada dentro del conexionismo: mostró de manera convincente que el método permitía entrenar redes de varias capas para resolver problemas concretos, y lo expuso con la claridad suficiente como para que la comunidad del campo lo hiciera propio. Este libro señala la diferencia entre inventar y establecer porque el relato simplificado —una pieza matemática ausente desde 1969 que aparece de golpe en 1986— resulta narrativamente satisfactorio pero históricamente inexacto. El capítulo 7 desarrolla el método con el detalle matemático correspondiente.
Sin embargo, y este es un punto que conviene subrayar porque contradice una idea intuitiva muy extendida, la disponibilidad de un método matemático correcto no bastó, por sí sola, para producir de inmediato sistemas prácticos y ampliamente utilizados. Durante los años noventa y buena parte de la primera década del dos mil, las redes neuronales de varias capas coexistieron con otros métodos estadísticos, como las máquinas de vectores de soporte y los métodos bayesianos, sin que ninguno de ellos produjera resultados que superaran de manera decisiva a los demás en la mayoría de las tareas prácticas. Este período, que carece de un nombre tan célebre como el de los inviernos anteriores pero que fue igual de real, muestra algo que va a resultar central para entender el capítulo siguiente de esta historia: una idea matemática correcta puede permanecer sin producir un impacto práctico decisivo durante décadas, hasta que se combina con las condiciones materiales adecuadas.
El quiebre de 2012 y la década del aprendizaje profundo
Sección titulada «El quiebre de 2012 y la década del aprendizaje profundo»Esas condiciones materiales —que este libro examinará con detalle técnico completo en el capítulo dedicado a la ingeniería de hardware e infraestructura— maduraron de manera convergente hacia el año 2012. Por un lado, la disponibilidad de conjuntos de datos masivos y cuidadosamente etiquetados, como la base de datos de imágenes conocida como ImageNet, construida mediante trabajo colaborativo a gran escala durante los años previos. Por otro lado, la posibilidad de usar tarjetas gráficas, originalmente diseñadas para procesar los gráficos de videojuegos, como procesadores de propósito general capaces de realizar las operaciones matriciales masivas que exige el entrenamiento de una red neuronal profunda, a una velocidad muchísimo mayor que la de un procesador convencional.
La consecuencia visible de esta convergencia fue el resultado obtenido en 2012 en la competencia anual de clasificación de imágenes organizada en torno a la base de datos ImageNet: una red neuronal profunda entrenada según estos principios, conocida por el nombre de su autor principal, redujo la tasa de error de clasificación de manera tan pronunciada respecto de los métodos previos basados en características diseñadas a mano, que la comunidad especializada interpretó el resultado como la prueba definitiva de que había llegado el momento de abandonar, en la mayoría de los dominios donde hasta entonces se habían aplicado, los métodos que requerían diseño manual de características, en favor de sistemas que aprendieran esas características directamente a partir de datos crudos.
Conviene ser muy preciso sobre la naturaleza de este quiebre, porque suele describirse de una manera que induce a error. Lo ocurrido en 2012 no fue un descubrimiento filosófico ni conceptual nuevo sobre la naturaleza del aprendizaje: el algoritmo de retropropagación que hizo posible entrenar esa red databa, como ya se explicó en este mismo capítulo, de 1986. Lo que ocurrió fue, exclusivamente, la convergencia simultánea de tres factores de naturaleza material y no teórica: una fuente de datos masivos y etiquetados que no existía antes de la expansión de la red de acceso público mundial —la propia base ImageNet, construida mediante trabajo colaborativo a través de esa red—, una forma de cómputo paralelo de bajo costo relativo que no había sido diseñada originalmente para este propósito —las tarjetas gráficas de videojuegos reutilizadas como procesadores de propósito general—, y un algoritmo de tres décadas de antigüedad que hasta entonces nadie había podido ejecutar a la escala necesaria para que su ventaja se manifestara con claridad. Ninguno de los tres factores, por separado, habría bastado: la teoría sin datos ni cómputo suficientes es exactamente la situación que ya existía, sin resultados prácticos notables, durante los veinticinco años previos a 2012. A partir de ese año, y de manera acelerada durante la década siguiente, el aprendizaje profundo se convirtió en el paradigma dominante en prácticamente todas las áreas de la inteligencia artificial aplicada: visión por computadora, reconocimiento de voz, traducción automática, y, hacia el final de esa misma década, el procesamiento del lenguaje natural en su forma más general.
Con esto, la escuela conexionista pasó a ocupar la posición dominante en la disputa de paradigmas que este capítulo viene narrando desde la sección dedicada a las dos escuelas en disputa. Pero conviene ser preciso sobre qué tipo de victoria fue esta, porque es fácil malinterpretarla. El triunfo del aprendizaje profundo en 2012 no demostró que el conexionismo fuera filosóficamente superior al simbolismo en algún sentido general y abstracto —la hipótesis del sistema de símbolos físicos de Newell y Simon no quedó refutada por ningún argumento lógico nuevo—; lo que ocurrió fue, más modestamente, que la convergencia de cómputo masivo y datos en abundancia permitió que el enfoque conexionista resolviera, de manera práctica, un problema muy concreto —cómo representar automáticamente las características relevantes de un dato crudo, sin diseño manual— que había paralizado durante décadas tanto a la escuela simbólica como al propio conexionismo en sus primeras versiones. Es una victoria de ingeniería y de condiciones materiales, documentada en los resultados, no una victoria filosófica sobre la naturaleza última de la cognición, pregunta que, como mostró el capítulo anterior de este libro, sigue sin tener una respuesta cerrada.
La arquitectura que definió la época actual: de la traducción automática a los sistemas conversacionales
Sección titulada «La arquitectura que definió la época actual: de la traducción automática a los sistemas conversacionales»El último tramo de esta historia, que llega hasta el momento presente, tiene un punto de inflexión más reciente y más fácil de fechar que los anteriores, aunque conviene contarlo con cuidado porque suele simplificarse en exceso. La pieza central de las arquitecturas actuales es el llamado mecanismo de atención, un procedimiento que permite a un sistema decidir, para cada parte de una secuencia, qué otras partes de esa misma secuencia resultan relevantes. Ese mecanismo no nació en 2017: fue propuesto en 2014 por Dzmitry Bahdanau, Kyunghyun Cho y Yoshua Bengio, precisamente para mejorar la traducción automática, y se usó durante los años siguientes como un complemento dentro de arquitecturas que seguían siendo, en lo esencial, recurrentes.
Lo que ocurrió en 2017 fue distinto, y por eso mismo decisivo: un grupo de investigadores publicó una arquitectura, conocida como Transformer, que prescindía de la recurrencia y de la convolución —los dos mecanismos que hasta entonces se consideraban indispensables para modelar una secuencia— y hacía de la atención el mecanismo central para relacionar entre sí los elementos de esa secuencia. Conviene no exagerar la fórmula: el Transformer no está compuesto únicamente por atención, sino que combina la atención con otros componentes que el capítulo 8 describe en detalle. Lo que cambió fue qué mecanismo se encarga de vincular las partes de una secuencia entre sí, y el título del artículo lo declaraba sin rodeos: para esa tarea, la atención bastaba. Este libro dedica un capítulo completo, con desarrollo matemático detallado, a explicar cómo funciona ese mecanismo. En términos puramente históricos, lo relevante es que esa arquitectura resultó tener una propiedad que sus autores no habían buscado explícitamente: escalaba de manera extraordinariamente eficiente al aumentar la cantidad de datos de entrenamiento, la cantidad de parámetros del modelo y la cantidad de cómputo disponible, mucho más eficientemente que las arquitecturas que la precedieron.
Esta propiedad de escalamiento es la que condujo, en los años siguientes, a los sistemas de lenguaje de gran escala que sostienen los asistentes conversacionales actuales, entrenados sobre cantidades de texto que abarcan una fracción sustancial de todo el texto disponible en formato digital, y ejecutados sobre infraestructuras de cómputo cuya escala, costo energético y organización física serán objeto de un capítulo propio de este libro, porque no se pueden entender de manera completa separadas de la matemática que las sostiene.
Lo que este capítulo deja establecido antes de continuar
Sección titulada «Lo que este capítulo deja establecido antes de continuar»El recorrido histórico completo, desde los autómatas mecánicos anteriores a la existencia de la computadora hasta los sistemas conversacionales actuales, deja establecidos varios puntos que este libro va a seguir usando en los capítulos que siguen.
En primer lugar, la disciplina nació de una decisión pragmática y explícita —tomada por sus propios fundadores en la conferencia de Dartmouth— de tratar la inteligencia como algo que se puede describir con precisión suficiente para ser simulado por una máquina, sin resolver antes las preguntas filosóficas sobre la naturaleza última de esa inteligencia que el capítulo anterior de este libro examinó en detalle. Esa disciplina, sin embargo, se dividió tempranamente en dos escuelas con supuestos muy distintos sobre cómo llevar a cabo ese programa: el paradigma simbólico, que dominó desde Dartmouth hasta fines de la década de 1980, y el paradigma conexionista, marginado durante ese mismo período pero triunfante desde 2012. Toda la historia narrada en este capítulo puede leerse como la crónica de esa disputa.
En segundo lugar, la historia del campo no es una línea recta de progreso continuo, sino una sucesión de ciclos de entusiasmo desproporcionado seguidos de decepción y retracción de recursos. Es importante retener la lección precisa de cada ciclo y no una versión simplificada de ella: el fracaso del perceptrón de una sola capa en 1969 fue una limitación matemática demostrable, no una falta de imaginación; y el colapso de los sistemas expertos hacia fines de la década de 1980 no ocurrió porque se agotaran las ideas sobre cómo representar el conocimiento, sino porque se vendió la promesa de un razonamiento de nivel humano en un momento en que ni la memoria física ni la capacidad de cómputo disponibles —ni, más profundamente, la posibilidad misma de capturar todo el conocimiento experto en reglas explícitas— podían sostener esa promesa. Ambas lecciones conviene tenerlas presentes como marco de referencia crítico para evaluar cualquier anuncio contemporáneo sobre el estado del campo.
En tercer lugar, y este es quizás el punto más importante para entender los capítulos siguientes de este libro, las ideas matemáticas centrales que sostienen los sistemas actuales —el aprendizaje mediante ajuste de parámetros a partir de ejemplos, y el propio algoritmo de retropropagación que hace posible ese ajuste en redes de varias capas— no son recientes: existen, en una forma reconocible, desde finales de la década de 1950 y mediados de la de 1980 respectivamente. Lo que produjo el cambio observable en la década de 2010 no fue, principalmente, un avance teórico nuevo, sino la convergencia de tres condiciones materiales —datos disponibles a gran escala, capacidad de cómputo especializada, y refinamientos algorítmicos incrementales— que este libro ya adelantó de manera general y que retomará con mucho más detalle técnico en la parte dedicada a la ingeniería física de estos sistemas.
El próximo capítulo deja, por el momento, la narrativa histórica de la disputa entre paradigmas, y examina un problema distinto aunque estrechamente relacionado: qué tipo de razonamiento, en sentido estrictamente lógico y epistemológico, es el que realiza un sistema que aprende a partir de ejemplos —el corazón mismo del paradigma conexionista que acaba de resultar vencedor—, y por qué ese tipo de razonamiento es estructuralmente distinto —y en un sentido preciso que el capítulo siguiente va a definir con rigor— del razonamiento deductivo que caracterizó al paradigma simbólico descrito en este mismo capítulo.
Notas y referencias del capítulo
Sección titulada «Notas y referencias del capítulo»- Turing, A. M. (1950). “Computing Machinery and Intelligence”. Mind, 59(236).
- Searle, J. (1980). “Minds, Brains, and Programs”. Behavioral and Brain Sciences, 3(3). (Argumento de la Habitación China.)
- Newell, A. & Simon, H. A. (1976). “Computer Science as Empirical Inquiry: Symbols and Search”. Communications of the ACM, 19(3). (Hipótesis del sistema de símbolos físicos; conferencia del Premio Turing.)
- McCarthy, J., Minsky, M., Rochester, N., & Shannon, C. (1955). “A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence”.
- Minsky, M. & Papert, S. (1969). Perceptrons: An Introduction to Computational Geometry. MIT Press.
- Lighthill, J. (1973). “Artificial Intelligence: A General Survey”. Informe encargado por el Science Research Council del Reino Unido.
- Rosenblatt, F. (1958). “The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain”. Psychological Review, 65(6).
- Sobre el colapso del mercado de máquinas Lisp (1987) y el problema de la cualificación en sistemas expertos: entrada “AI winter”, y McCorduck, P. (2004). Machines Who Think. A K Peters.
- Boole, G. (1847). The Mathematical Analysis of Logic; Boole, G. (1854). An Investigation of the Laws of Thought.
- Linnainmaa, S. (1970). Algoritmin kumulatiivinen pyöristysvirhe. Tesis de maestría, Universidad de Helsinki. (Desarrollo del modo reverso de diferenciación automática, principio matemático que sustenta la retropropagación.) Werbos, P. (1974). Beyond Regression: New Tools for Prediction and Analysis in the Behavioral Sciences. Tesis doctoral, Universidad de Harvard. (Aplicación temprana al entrenamiento de redes.)
- Bahdanau, D., Cho, K., & Bengio, Y. (2014). “Neural Machine Translation by Jointly Learning to Align and Translate”. arXiv:1409.0473. (Introducción del mecanismo de atención, tres años anterior a la arquitectura Transformer.)
- Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). “Learning representations by back-propagating errors”. Nature, 323.
- Deng, J. et al. (2009). “ImageNet: A Large-Scale Hierarchical Image Database”. CVPR.
- Krizhevsky, A., Sutskever, I., & Hinton, G. E. (2012). “ImageNet Classification with Deep Convolutional Neural Networks”. NeurIPS.
- Vaswani, A. et al. (2017). “Attention Is All You Need”. NeurIPS.
- Crevier, D. (1993). AI: The Tumultuous History of the Search for Artificial Intelligence. Basic Books.
Copyright © 2026 Carlos Dagorret — Licencia Creative Commons Atribución-NoComercial-SinDerivadas 4.0 Internacional (CC BY-NC-ND 4.0)