8. Arquitecturas modernas: los Transformers y los modelos de lenguaje
El problema de procesar una secuencia
Sección titulada «El problema de procesar una secuencia»Las redes neuronales tal como se las presenta habitualmente —y como las desarrolla el capítulo 7— procesan su entrada como un único vector de tamaño fijo: una lista de números de longitud predeterminada. Eso funciona razonablemente bien para una imagen de dimensiones conocidas, pero resulta poco natural para datos que llegan como una secuencia de longitud variable, como una oración de un idioma natural, donde el orden importa y donde dos oraciones distintas tienen cantidades distintas de palabras. Antes de presentar la arquitectura que resolvió este problema de la manera que hoy domina el campo, conviene entender, con precisión, por qué el enfoque más directo e intuitivo para procesar secuencias —leer un elemento a la vez, en orden, actualizando una especie de memoria interna después de cada uno— resultó, en la práctica, insuficiente.
Ese enfoque, llamado red neuronal recurrente, procesa una secuencia de un elemento a la vez, y en cada paso combina el elemento actual con un vector que resume todo lo procesado hasta ese momento, produciendo un nuevo vector resumen que se pasa al paso siguiente. Este esquema respeta el orden de la secuencia por construcción, pero hereda, en una forma agravada, un problema conocido como desvanecimiento del gradiente: para que la información del primer elemento de una secuencia larga influya en la predicción correspondiente al último, esa información tiene que sobrevivir, sin desvanecerse, a través de tantos pasos de multiplicación sucesiva como elementos haya en el medio, algo que en secuencias largas resulta, en la práctica, extremadamente difícil de lograr. Además, y esto tiene consecuencias de ingeniería tan importantes como las puramente matemáticas, el hecho de que cada paso dependa por definición del resultado del paso anterior impide procesar los distintos elementos de una secuencia en paralelo, desperdiciando precisamente la ventaja del cómputo masivamente paralelo de las tarjetas gráficas que el capítulo dedicado a los fundamentos de ingeniería de este libro presentó como decisiva para el aprendizaje profundo.
Tokenización: de las palabras a las unidades que el modelo realmente procesa
Sección titulada «Tokenización: de las palabras a las unidades que el modelo realmente procesa»Antes de poder procesar cualquier texto, hace falta resolver un problema previo que este libro, hasta aquí, simplificó de manera deliberada al hablar de “palabras”. En la práctica, los sistemas de lenguaje actuales no dividen un texto en palabras completas, sino en unidades más pequeñas y más flexibles llamadas tokens, mediante un proceso llamado tokenización. Un token puede ser una palabra completa si esa palabra es lo bastante frecuente, pero también puede ser una porción de una palabra más larga o menos frecuente —un prefijo, un sufijo, o incluso una sola sílaba—, de modo que cualquier palabra, incluidas las que el sistema nunca vio durante su entrenamiento, se pueda representar como una combinación de un número relativamente pequeño de estas unidades.
Este diseño resuelve un problema práctico concreto: si el sistema solo pudiera representar palabras completas ya vistas durante el entrenamiento, cualquier palabra nueva, cualquier nombre propio, cualquier error de tipeo o cualquier palabra de otro idioma resultaría imposible de procesar. Dividiendo el texto en unidades más pequeñas y combinables, el sistema puede representar, en principio, cualquier secuencia de texto, incluso una que nunca haya aparecido de esa forma exacta en sus datos de entrenamiento, componiéndola a partir de fragmentos que sí conoce. De aquí en más, este libro usará la palabra token en los lugares donde la precisión técnica lo exige, y seguirá usando “palabra” solo como una simplificación intuitiva cuando la distinción entre ambas no sea relevante para el argumento que se está desarrollando; el lector debe entender que, en el mecanismo real que se describe a continuación, cada “palabra” del texto de entrada es, más precisamente, una secuencia de uno o más tokens.
Representar un token como vector: los embeddings
Sección titulada «Representar un token como vector: los embeddings»Con el texto ya dividido en tokens, hace falta resolver el problema que este libro adelantó de manera general en el capítulo dedicado a los fundamentos matemáticos: convertir cada token en un vector de números. La solución que domina el campo desde mediados de la década de 2010 no asigna estos vectores de manera arbitraria, sino que los aprende, durante el entrenamiento, de tal manera que tokens que aparecen en contextos similares terminan representados por vectores que apuntan en direcciones similares, medida esa similitud, precisamente, mediante la similitud coseno que el capítulo dedicado a los fundamentos matemáticos presentó como la manera adecuada de comparar vectores en espacios de muchas dimensiones. A estos vectores aprendidos se los llama embeddings.
Una de las propiedades más citadas de los primeros sistemas de embeddings, desarrollados antes de la arquitectura Transformer que este capítulo presenta más adelante, es que ciertas relaciones semánticas entre palabras parecían reflejarse en relaciones geométricas simples entre sus vectores: el vector resultante de tomar el vector de “rey”, restarle el vector de “hombre” y sumarle el vector de “mujer”, se acercaba, de manera aproximada, al vector de “reina”. Conviene ser precisos sobre el alcance real de este ejemplo, tan repetido en la divulgación del campo: describe una propiedad de los embeddings estáticos más tempranos, en los que cada palabra recibía un único vector fijo, igual en cualquier oración en la que apareciera. Los sistemas actuales, como se explica en la sección siguiente, no funcionan exactamente así: el mecanismo de atención transforma la representación de cada token en función del resto de la secuencia en la que aparece, de modo que la representación interna de una misma palabra cambia según el contexto —la palabra “banco” tiene una representación distinta en “banco de plaza” que en “banco de dinero” dentro de un Transformer, algo que un embedding estático de la generación anterior no podía capturar—. El ejemplo de “rey menos hombre más mujer” sigue siendo útil como antecedente histórico conceptual, que introduce la idea de que la geometría vectorial puede reflejar relaciones semánticas, pero no describe con precisión cómo funcionan las representaciones contextuales internas de un Transformer moderno.
Conviene ser precisos, además, sobre qué significa esta propiedad geométrica en general, porque el capítulo dedicado a Searle y a la teoría de la información de Shannon en los primeros capítulos de este libro obliga a esa precisión. Que la geometría de estos vectores refleje regularidades estadísticas del uso de los tokens en enormes cantidades de texto no equivale, sin más, a que el sistema comprenda el significado de esos tokens en el sentido semántico pleno que Searle exigía en su argumento de la Habitación China, presentado en el capítulo dedicado a la historia de la inteligencia artificial: es, más precisamente, una regularidad sintáctica de altísimo orden, capturada con una fidelidad notable, sobre patrones de coocurrencia entre símbolos. Este libro retoma esta distinción, con todo el desarrollo que merece, en el capítulo dedicado a los límites filosóficos de estos sistemas.
El mecanismo de atención: relacionar todos los tokens entre sí a la vez
Sección titulada «El mecanismo de atención: relacionar todos los tokens entre sí a la vez»El mecanismo que permitió superar estas dos limitaciones se llama atención, y conviene situarlo históricamente con precisión antes de desarrollarlo. Fue propuesto en 2014 por Bahdanau, Cho y Bengio como un complemento dentro de arquitecturas recurrentes, para que el sistema pudiera consultar directamente cualquier parte de la secuencia de entrada en lugar de depender de un único resumen acumulado. Durante tres años funcionó así, como una mejora añadida a un esquema que seguía siendo secuencial. Lo que se presentó en 2017, bajo el nombre de Transformer, fue una arquitectura que prescindía de la recurrencia y de la convolución, y hacía de la atención el mecanismo central para relacionar entre sí los elementos de una secuencia. La contribución no fue inventar la atención, sino reorganizar la arquitectura alrededor de ella. Como se verá en las secciones siguientes, un Transformer contiene además otros componentes indispensables —capas de avance, conexiones residuales, normalización, representaciones aprendidas de cada unidad de texto—, de modo que decir que consiste solamente en atención sería inexacto: lo que la atención reemplazó fue, específicamente, el mecanismo de vinculación entre posiciones de la secuencia.
El mecanismo merece un desarrollo matemático completo porque es, en un sentido preciso, la generalización natural de una idea que este libro ya presentó de manera aislada: el producto interno como medida de similitud entre vectores, que desarrolla el capítulo 4.
La idea central del mecanismo de atención es que, para procesar un token dentro de una secuencia, en lugar de depender de un resumen secuencial acumulado paso a paso como en una red recurrente, el sistema compara ese token, de manera directa y simultánea, con todos los demás tokens de la secuencia, y decide, en función de esa comparación, cuánto “peso” o cuánta atención darle a cada uno de ellos para construir una representación enriquecida del token en cuestión. A cada token de la secuencia se le asocian, mediante tres matrices de pesos ajustables independientes, tres vectores distintos, llamados consulta, clave y valor. El vector de consulta de un token representa, informalmente, qué está “buscando” ese token en el resto de la secuencia; el vector de clave de cada token representa qué información ese token “ofrece” a los demás; y el vector de valor contiene la información real que se transmitirá si la atención recae sobre ese token.
Una consecuencia notable de este mecanismo, que conviene señalar de manera explícita, es que, tal como está descrito hasta aquí, no distingue en absoluto el orden de los tokens: si se permutara el orden de una secuencia completa, el cálculo de atención entre cada par de tokens daría exactamente el mismo resultado, porque el producto interno entre dos vectores no depende de dónde se ubiquen esos vectores dentro de una lista. Para que la arquitectura pueda distinguir, por ejemplo, entre “el perro mordió al cartero” y “el cartero mordió al perro”, se le añade a cada vector de entrada una información adicional, llamada codificación posicional, que indica de manera explícita en qué posición de la secuencia se encuentra cada token, antes de que ese token entre al mecanismo de atención recién descrito.
La arquitectura completa del Transformer repite varias veces en paralelo este mismo cálculo de atención —lo que se llama atención de varias cabezas, permitiendo que cada repetición aprenda a capturar un tipo distinto de relación entre tokens.
Más allá de la atención: conexiones residuales, normalización y la capa de avance
Sección titulada «Más allá de la atención: conexiones residuales, normalización y la capa de avance»El mecanismo de atención, por sí solo, no compone todavía la arquitectura completa de un Transformer, y este libro no puede llamar completo a su desarrollo matemático sin presentar las tres piezas adicionales que lo hacen entrenable en la práctica a la profundidad que estos sistemas requieren.
La primera pieza son las conexiones residuales. Apilar muchas capas agrava un problema conocido como desvanecimiento del gradiente: durante el entrenamiento, la señal que indica cómo corregir cada parámetro tiene que atravesar tantas multiplicaciones sucesivas como capas haya, y si esos factores son pequeños, el producto de muchos de ellos se acerca a cero, de modo que las capas más alejadas de la salida dejan de recibir información útil para ajustarse. El capítulo 7 desarrolla este problema en detalle. Una conexión residual introduce un atajo: en lugar de que la salida de un bloque de capas sea, únicamente, el resultado de transformar la entrada, esa salida se calcula sumando el resultado de la transformación a la entrada original, sin modificar, que se sumó al resultado de exactamente la manera en que se combinan dos vectores según el capítulo dedicado a los fundamentos matemáticos de este libro. Esta suma directa le da al gradiente, durante la retropropagación, un camino alternativo para propagarse hacia las capas más profundas sin tener que atravesar necesariamente cada transformación intermedia, de manera muy parecida a como una autopista directa evita las intersecciones de una ciudad congestionada. Esta técnica, más que cualquier función de activación en particular, es la que permitió entrenar redes de una profundidad muy superior a la que era práctica antes de su introducción; la elección de la función de activación —la operación no lineal que se aplica a la salida de cada capa— también contribuye a mitigar el desvanecimiento del gradiente, pero conviene precisar que esa mitigación es una entre varias técnicas complementarias —junto con las conexiones residuales, con esquemas de inicialización de pesos más cuidadosos y con la normalización que se describe a continuación— y no la explicación única ni suficiente por sí sola del entrenamiento práctico de redes muy profundas.
La segunda pieza es la normalización de capa, una operación que reescala los valores numéricos que circulan dentro de la red, en cada capa, para que mantengan un rango de magnitudes consistente a medida que atraviesan la arquitectura. Sin este reescalado, los valores producidos por capas sucesivas pueden crecer o encogerse de manera descontrolada a medida que aumenta la profundidad de la red, un problema distinto pero relacionado con el desvanecimiento del gradiente, y que puede desestabilizar el proceso de descenso de gradiente presentado en el capítulo dedicado a los fundamentos matemáticos de este libro. La normalización de capa actúa, en cada punto de la red donde se aplica, restando el promedio y dividiendo por la dispersión de los valores que está procesando en ese momento, una operación estadística directamente construida sobre los conceptos de promedio y de dispersión que el capítulo dedicado a los fundamentos matemáticos de este libro ya presentó al hablar de probabilidad.
La tercera pieza es una capa de avance, que es, en realidad, una red neuronal en su forma más simple: una combinación lineal de las entradas seguida de una función de activación no lineal, aplicada de manera independiente a la representación de cada token después de que el mecanismo de atención ya mezcló información entre los distintos tokens de la secuencia. Si la atención es la etapa en la que los tokens de una secuencia “conversan” entre sí, la capa de avance es la etapa en la que cada token, ya enriquecido con esa conversación, procesa esa información de manera individual antes de pasar al bloque siguiente.
Un bloque completo de la arquitectura Transformer combina estas piezas en un orden específico: atención de varias cabezas con su conexión residual y su normalización, seguida de una capa de avance con su propia conexión residual y su propia normalización. Ese bloque completo se apila muchas veces, una detrás de otra, para formar la profundidad total de la red. El resultado final, después de atravesar todos estos bloques, es una representación enriquecida de cada token que incorpora información relevante de todos los demás tokens de la secuencia, sobre la cual se calcula, finalmente, una distribución de probabilidad sobre cuál debería ser el siguiente token de la secuencia, usando exactamente el mismo mecanismo de softmax y entropía cruzada que el capítulo dedicado al aprendizaje automático clásico presentó para la clasificación.
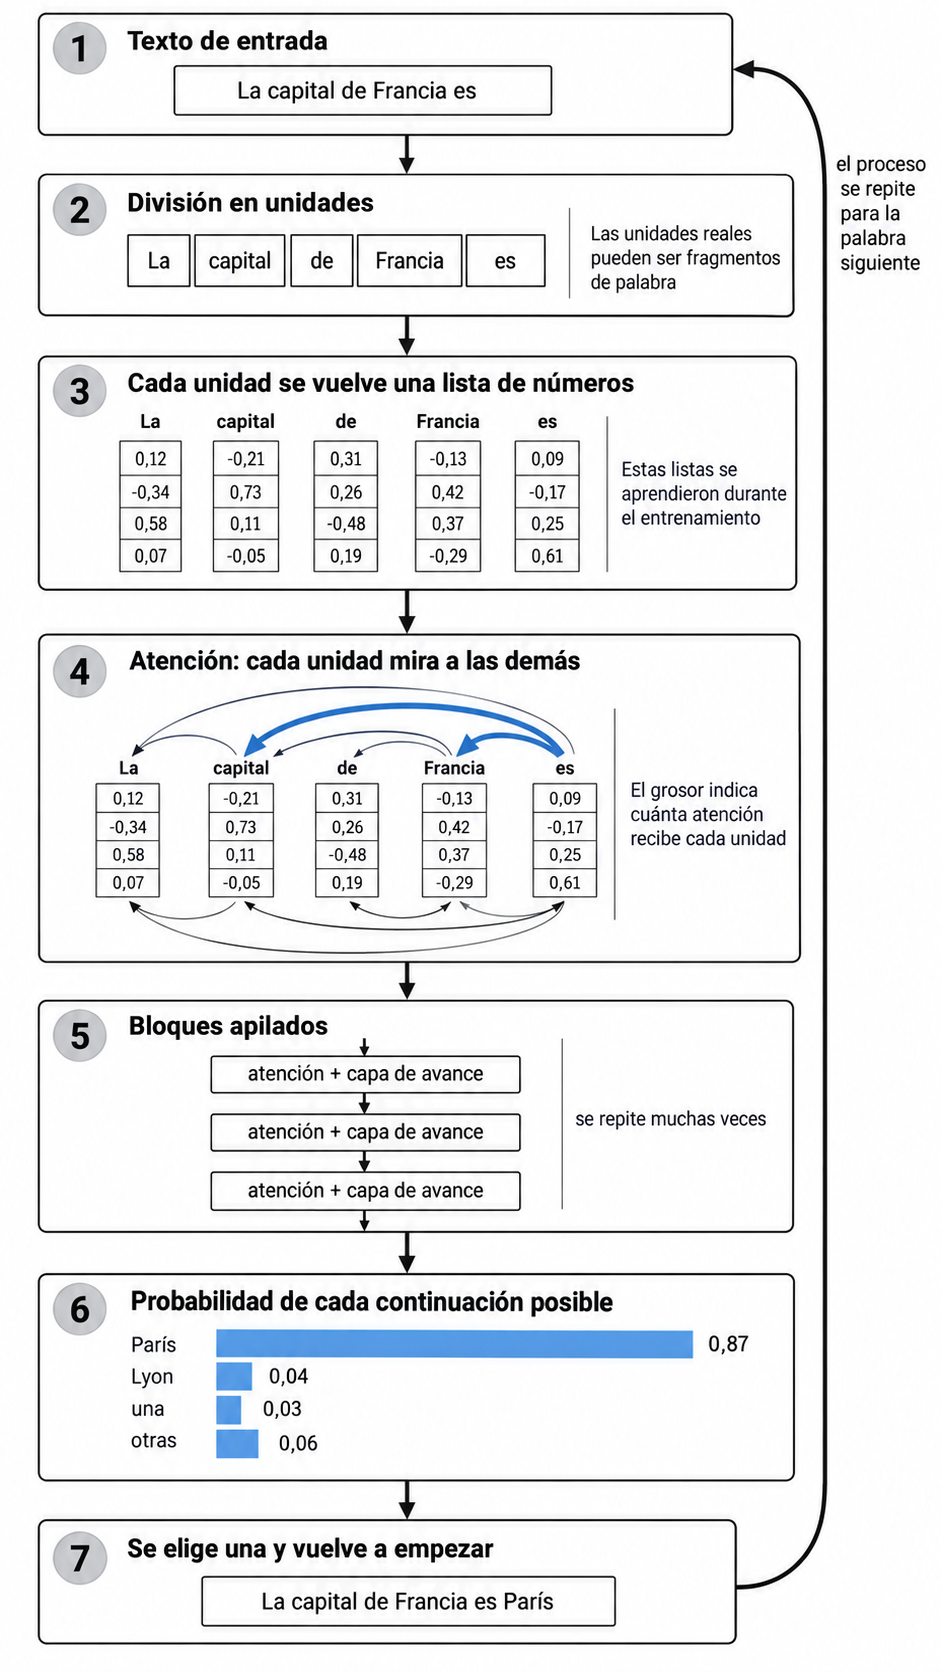
Figura 8.1. El recorrido completo, desde un texto de entrada hasta la palabra siguiente. El sistema divide el texto en unidades, las convierte en listas de números, permite que cada una tome en cuenta a las demás, repite ese procesamiento muchas veces, y produce finalmente una probabilidad para cada continuación posible. Elegida una, todo el proceso vuelve a empezar.
Cómo se genera una respuesta: de la distribución de probabilidad al texto final
Sección titulada «Cómo se genera una respuesta: de la distribución de probabilidad al texto final»Con el modelo ya entrenado, queda una pregunta que este capítulo no puede dejar sin responder: dado que, en cada paso, el sistema produce una distribución de probabilidad completa sobre miles de tokens posibles, ¿cómo se elige, exactamente, cuál de ellos formará parte de la respuesta final?
La opción más simple, llamada decodificación voraz, consiste en elegir siempre el token con la probabilidad más alta en cada paso. Esta opción es determinista —el mismo texto de entrada siempre produce exactamente la misma respuesta— pero tiende a generar un texto repetitivo y, en cierto sentido, menos natural, porque el lenguaje humano no elige siempre, palabra a palabra, la continuación más predecible. La alternativa, llamada muestreo, consiste en elegir el siguiente token al azar, pero respetando la distribución de probabilidad que el modelo calculó, de modo que los tokens más probables tienen más chances de ser elegidos sin que los menos probables queden completamente excluidos, introduciendo así la variedad que el lenguaje humano efectivamente exhibe.
Este muestreo se controla, en la práctica, mediante algunos parámetros adicionales. La temperatura es un número que se usa para suavizar o para acentuar la distribución de probabilidad original antes de muestrear: una temperatura baja acerca el comportamiento del sistema a la decodificación voraz, favoreciendo fuertemente a los tokens más probables, mientras que una temperatura alta aplana la distribución, dando más chances relativas a tokens menos probables y produciendo un texto más variado pero también más propenso a desviarse de lo esperado. Dos técnicas adicionales, llamadas muestreo por los k tokens más probables y muestreo por núcleo de probabilidad acumulada, restringen el muestreo a un subconjunto de los tokens más plausibles —ya sea una cantidad fija de ellos, o los suficientes para acumular una proporción determinada de la probabilidad total—, evitando que el azar del muestreo elija, alguna vez, uno de los tokens con probabilidad extremadamente baja que la larga cola de la distribución casi siempre contiene.
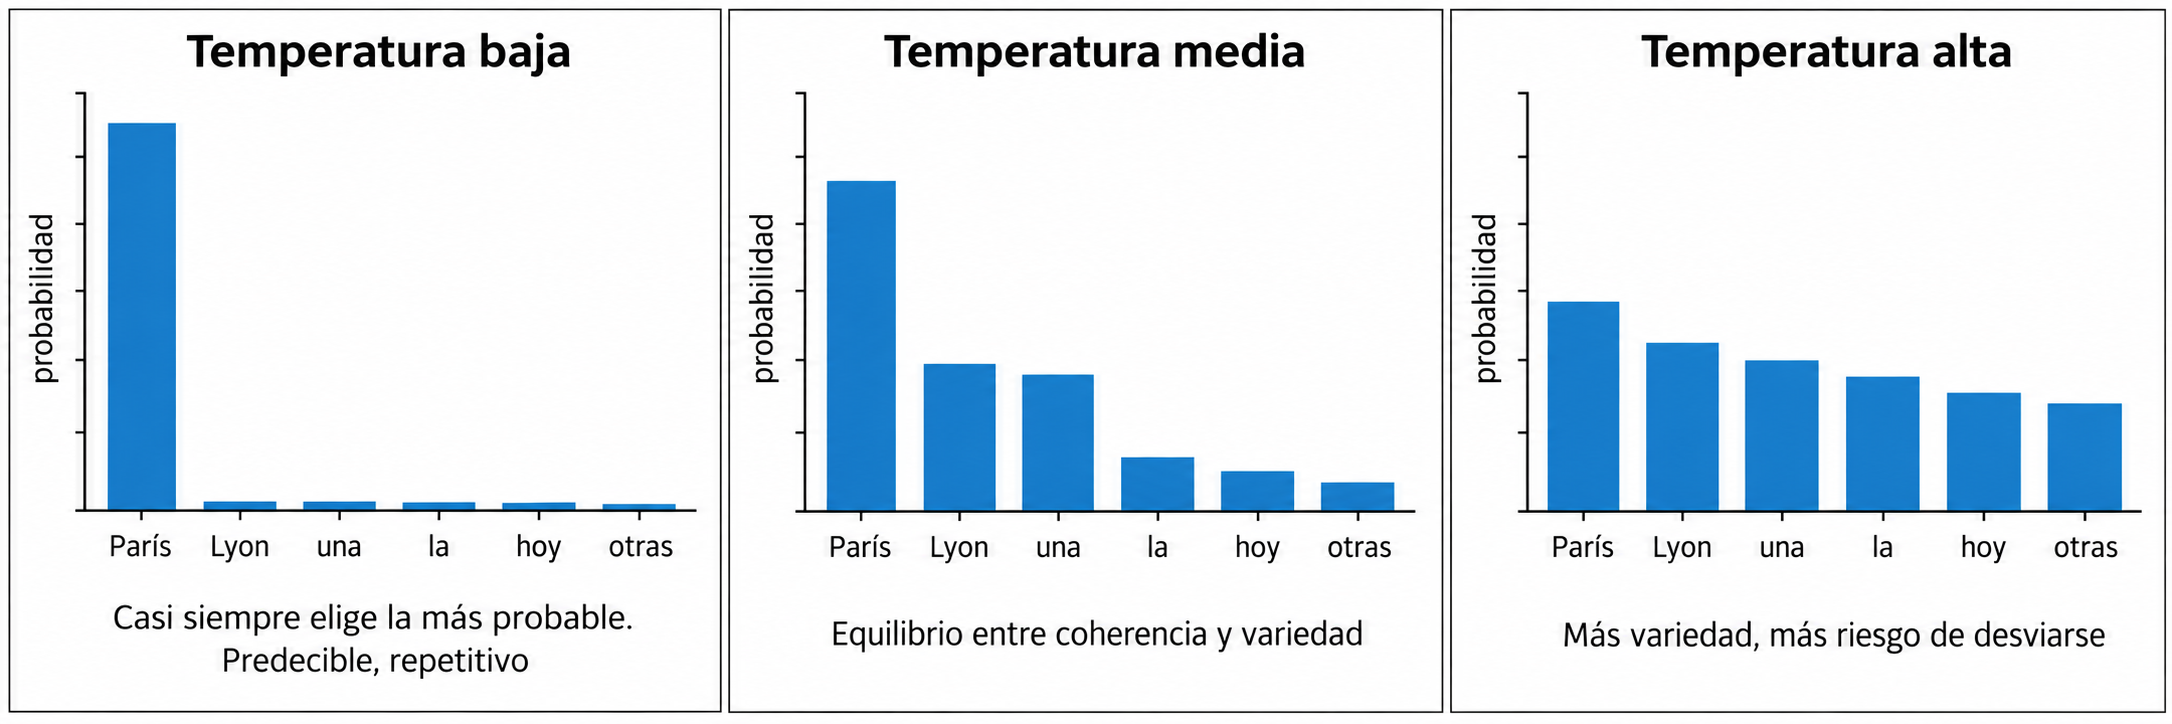
Figura 8.2. El efecto de la temperatura. El mismo sistema, con los mismos parámetros internos, puede comportarse de manera casi determinista o considerablemente más variada según cómo se ajuste este valor antes de elegir la palabra siguiente. La temperatura no modifica lo que el modelo aprendió: solo cambia cómo se elige entre lo que el modelo considera posible.
Conviene señalar, además, un aspecto de ingeniería que conecta directamente esta sección con el capítulo dedicado a los fundamentos de ingeniería de este libro. Generar una respuesta no ocurre en un único paso: el modelo produce un token, lo agrega al final de la secuencia de entrada, y vuelve a ejecutar el procesamiento necesario sobre la secuencia extendida para producir el siguiente token, repitiendo este ciclo tantas veces como tokens tenga la respuesta final. Recalcular, en cada uno de estos pasos, los vectores de clave y de valor de todos los tokens anteriores —que no cambiaron desde el paso previo— sería un desperdicio evidente de cómputo; por eso, en la práctica, estos sistemas conservan esos vectores ya calculados en una memoria auxiliar, llamada caché de clave y valor, y solo calculan los vectores correspondientes al token nuevo en cada paso, reutilizando el resto. Esta técnica, puramente de ingeniería y sin ningún efecto sobre el resultado matemático final, es la que hace viable, en términos del ancho de banda de memoria presentado en el capítulo dedicado a los fundamentos de ingeniería de este libro, generar respuestas de una longitud razonable en un tiempo razonable.
Finalmente, ningún modelo puede procesar una secuencia de longitud arbitraria: existe siempre una cantidad máxima de tokens, llamada ventana de contexto, que el sistema puede tener en cuenta a la vez, tanto de la entrada como de la respuesta que va generando. Una consecuencia directa de todo lo explicado en la sección del mecanismo de atención es que el costo de calcular esa atención crece, para cada par de tokens de la secuencia, con el cuadrado de la longitud de esa secuencia, lo cual explica por qué extender la ventana de contexto de estos sistemas ha sido, históricamente, un problema tanto matemático como de ingeniería, y no una simple cuestión de asignarle más memoria a la tarea.
El entrenamiento en varias fases: preentrenamiento, ajuste por instrucciones y alineación de preferencias
Sección titulada «El entrenamiento en varias fases: preentrenamiento, ajuste por instrucciones y alineación de preferencias»Los modelos de lenguaje que sostienen los sistemas conversacionales actuales se entrenan, típicamente, en varias fases sucesivas y muy distintas entre sí. En la primera fase, llamada preentrenamiento, el modelo se entrena sobre una cantidad extraordinariamente grande de texto —una fracción sustancial de todo el texto disponible en formato digital, según ya señaló el capítulo dedicado a la historia de la inteligencia artificial de este libro— con una tarea de entrenamiento muy simple de formular, aunque computacionalmente muy costosa de ejecutar a esta escala: dado un fragmento de texto, predecir cuál es el token siguiente, ajustando los parámetros del modelo, mediante retropropagación, para minimizar la entropía cruzada entre la predicción del modelo y el token que efectivamente sigue en el texto real. Esta tarea no requiere que ningún humano etiquete manualmente los datos de entrenamiento —la propia estructura secuencial del texto ya existente en el mundo proporciona, de manera automática, tanto la entrada como la etiqueta correcta para cada ejemplo—, lo cual es lo que permite entrenar sobre cantidades de texto tan grandes.
El modelo resultante de esta primera fase, sin embargo, está entrenado únicamente para continuar texto de la manera más plausible posible, no para seguir instrucciones ni para conversar de manera útil. Por eso, en una segunda fase, llamada ajuste por instrucciones, el modelo se entrena adicionalmente sobre una cantidad mucho más pequeña de ejemplos que muestran, de manera explícita, el formato de una instrucción seguida de la respuesta deseada, usando exactamente el mismo mecanismo de entropía cruzada de la primera fase, pero ahora sobre datos construidos específicamente para enseñarle al sistema el patrón de comportamiento conversacional que se espera de él.
Una tercera fase, llamada alineación de preferencias, refina todavía más ese comportamiento, esta vez usando no ejemplos de respuestas correctas escritas de antemano, sino comparaciones entre distintas respuestas posibles del propio modelo, indicando cuál de ellas resulta preferible según algún criterio —utilidad, seguridad, adecuación al pedido— definido por quienes lo desarrollan. Una de las técnicas usadas para esta fase, conocida como aprendizaje por refuerzo a partir de retroalimentación humana, entrena un modelo auxiliar para predecir qué respuesta preferiría un evaluador humano, y usa ese modelo auxiliar como señal para seguir ajustando los pesos del modelo principal mediante una variante del descenso de gradiente presentado en el capítulo dedicado a los fundamentos matemáticos de este libro. Esta no es, sin embargo, la única familia de técnicas disponible para esta fase: existen métodos más recientes que optimizan directamente las preferencias observadas entre pares de respuestas, sin necesidad de entrenar por separado ese modelo auxiliar ni de recurrir al aparato completo del aprendizaje por refuerzo clásico. Este libro no desarrolla aquí el detalle técnico completo de estas variantes, que constituyen, hoy, un área de investigación activa por derecho propio; lo que interesa señalar es la distinción conceptual entre las fases, retomando la que el capítulo dedicado a la lógica y la epistemología de este libro estableció entre inducción y abducción: durante el preentrenamiento, el modelo realiza, de manera masiva y repetida, la inducción de patrones estadísticos generales del lenguaje a partir de una cantidad enorme de ejemplos; en el momento de responder a una consulta concreta, ya con sus parámetros fijados tras todas las fases de entrenamiento, lo que el modelo hace es seleccionar la continuación más plausible dado ese texto de entrada particular, una operación que el capítulo 3 compara —con las reservas que allí se explican— con la abducción.
Lo que este capítulo deja establecido antes de continuar
Sección titulada «Lo que este capítulo deja establecido antes de continuar»Este capítulo mostró cómo la arquitectura Transformer resuelve, mediante el mecanismo de atención combinado con conexiones residuales, normalización y capas de avance, tanto el problema del desvanecimiento del gradiente en secuencias largas como el desaprovechamiento del paralelismo que limitaban a las redes recurrentes, generalizando para ello la operación de producto interno presentada desde el capítulo dedicado a los fundamentos matemáticos de este libro. Mostró también cómo, a partir de la distribución de probabilidad que el modelo produce en cada paso, se genera efectivamente el texto final mediante distintas estrategias de decodificación, y cómo el entrenamiento completo de estos sistemas se organiza en varias fases sucesivas, cada una con un objetivo distinto. Señaló, además, que la propiedad más citada de estos sistemas —que las relaciones semánticas entre palabras parecen reflejarse en la geometría de sus representaciones vectoriales— debe leerse con la misma cautela que exigió, desde el primer capítulo de este libro, la distinción entre procesamiento sintáctico y comprensión semántica genuina.
Con esta arquitectura ya desarrollada en su forma matemática completa, queda pendiente una pregunta que este capítulo dejó deliberadamente de lado: sobre qué máquina física, y con qué límites de escala, se entrena efectivamente un sistema de estas características, cuando sus parámetros se cuentan en cientos de miles de millones y sus datos de entrenamiento en billones de tokens. El próximo capítulo, que cierra la segunda parte de este libro, retoma exactamente esa pregunta.
Notas y referencias del capítulo
Sección titulada «Notas y referencias del capítulo»- Bahdanau, D., Cho, K., & Bengio, Y. (2014). “Neural Machine Translation by Jointly Learning to Align and Translate”. arXiv:1409.0473. (Introducción del mecanismo de atención.)
- Vaswani, A. et al. (2017). “Attention Is All You Need”. NeurIPS. (Ya citado en el capítulo de historia de la Inteligencia Artificial; se desarrolla aquí en detalle matemático completo.)
- Sobre las limitaciones de las redes neuronales recurrentes frente a secuencias largas: Hochreiter, S. & Schmidhuber, J. (1997). “Long Short-Term Memory”. Neural Computation, 9(8). (Intento previo de mitigar el desvanecimiento del gradiente en redes recurrentes, superado en la práctica por la arquitectura Transformer.)
- Sobre los embeddings estáticos de palabras y sus regularidades geométricas: Mikolov, T. et al. (2013). “Efficient Estimation of Word Representations in Vector Space”. arXiv:1301.3781.
- Sobre la tokenización mediante unidades de subpalabra: Sennrich, R., Haddow, B., & Birch, A. (2016). “Neural Machine Translation of Rare Words with Subword Units”. ACL.
- Sobre las conexiones residuales y su rol en el entrenamiento de redes muy profundas: He, K. et al. (2016). “Deep Residual Learning for Image Recognition”. CVPR.
- Sobre la normalización de capa: Ba, J. L., Kiros, J. R., & Hinton, G. E. (2016). “Layer Normalization”. arXiv:1607.06450.
- Searle, J. (1980). “Minds, Brains, and Programs”. Behavioral and Brain Sciences, 3(3). (Ya citado en el capítulo de historia de la Inteligencia Artificial; se retoma aquí para calificar la interpretación de los embeddings.)
- Sobre el ajuste por instrucciones y el aprendizaje por refuerzo a partir de retroalimentación humana: Ouyang, L. et al. (2022). “Training Language Models to Follow Instructions with Human Feedback”. NeurIPS.
- Sobre métodos de alineación de preferencias que no requieren el aparato completo del aprendizaje por refuerzo clásico: Rafailov, R. et al. (2023). “Direct Preference Optimization: Your Language Model is Secretly a Reward Model”. NeurIPS.
Copyright © 2026 Carlos Dagorret — Licencia Creative Commons Atribución-NoComercial-SinDerivadas 4.0 Internacional (CC BY-NC-ND 4.0)